統計應用|單元 4:抽樣分配與中央極限定理——從一個樣本看見整個母體
SuhsiungAI學習教室 授課教師:蘇志雄
適用對象:大學部・統計初學者 實作工具:Python(numpy、scipy.stats、pandas、matplotlib)
預估學習時間:講義閱讀 80 分鐘+實作 90 分鐘
← 上一單元:單元 3:機率與常見分配——用數字描述不確定性
本單元學習目標
完成本單元後,你將能夠:
- 區分母體與樣本、參數與統計量,並說清楚母體分配、樣本資料分配、抽樣分配三者的差別。
- 說明樣本平均數 x̄ 的抽樣分配:它的中心是 μ、標準差是 σ/√n。
- 理解標準誤(Standard Error, SE)的意義,並區分「標準差」與「標準誤」;知道「樣本數變 4 倍,標準誤才減半」。
- 陳述中央極限定理(CLT),並用 numpy 模擬指數分配、卜瓦松分配、students.csv 睡眠時數等非常態母體,親眼看到 x̄ 的分配隨 n 變大而接近常態。
- 計算樣本比例 p̂ 的抽樣分配與標準誤,解釋「民調 1,068 份樣本、誤差 ±3%」的由來,並檢查 np ≥ 10、n(1 − p) ≥ 10 的條件。
- 初步認識 t 分配:為什麼 σ 未知、改用樣本標準差 s 時,臨界值要比 1.96 大。
- 判斷中央極限定理什麼時候會失靈:樣本太小又嚴重偏態、厚尾分配(如柯西分配)、資料不獨立或抽樣有偏差。
一、為什麼要學抽樣分配?
單元 3 用機率分配描述「一個個體」的不確定性,例如一位同學的身高、一個月捷運誤點的天數。但真實的統計工作幾乎都是:手上只有一個樣本,卻想知道整個母體。
- 🗳️ 民調樣本數:全台灣約 1,900 多萬名選民,民調只訪問約 1,000 人,為什麼敢說「誤差在 ±3 個百分點以內」?
- 🧋 手搖飲杯量抽檢:店家標示「大杯 700 mL」,稽查人員只抽 9 杯量一量,就能判斷機器是否裝太少嗎?
- 🚌 通勤時間:學校想知道全校學生平均通勤多久,隨機問 64 位同學得到的平均,離真正的平均會差多少?
這三個問題的共同核心是:如果重新抽一次樣本,答案會變多少?描述「統計量在重複抽樣下怎麼變動」的,就是本單元的主角——抽樣分配。
💡 重點觀念:抽樣分配是「機率」通往「推論」的最後一塊拼圖。下一單元的信賴區間、之後的假設檢定,都是直接站在抽樣分配與中央極限定理的肩膀上。
二、母體、樣本與三種分配
1. 參數與統計量
| 名詞 | 意義 | 常用符號 | 例子:全校學生的睡眠時數 |
|---|---|---|---|
| 母體(Population) | 我們想了解的「全部」對象 | 大小 N | 全校所有學生 |
| 樣本(Sample) | 從母體中實際觀察到的一部分 | 大小 n | 隨機問到的 30 位同學 |
| 參數(Parameter) | 描述母體的數字,固定但通常未知 | μ、σ、p | 全校平均睡眠時數 μ |
| 統計量(Statistic) | 由樣本算出來的數字,會隨樣本改變 | x̄、s、p̂ | 這 30 人的平均睡眠時數 x̄ |
⚠️ 參數是固定的,統計量是隨機的。全校的 μ 只有一個值(只是我們不知道);但換一批同學,x̄ 就會不一樣。正因為 x̄ 是「隨機變數」,它才有自己的機率分配。
2. 三種分配,千萬別搞混
| 分配 | 描述的對象 | 每一個「資料點」是 | 例子 |
|---|---|---|---|
| 母體分配 | 母體中每個個體的值 | 一位學生的睡眠時數 | 全校學生睡眠時數的直方圖 |
| 樣本資料分配 | 一個樣本中各個觀察值 | 樣本中一位同學的睡眠時數 | 你問到的 30 人的直方圖 |
| 抽樣分配(Sampling Distribution) | 統計量在「所有可能樣本」下的分配 | 一整個樣本算出來的 x̄ | 抽 1 萬次樣本、得到 1 萬個 x̄ 的直方圖 |
抽樣分配是「想像中的」分配:現實中我們只會抽一次樣本,但可以用理論(本單元的公式與 CLT)或電腦模擬(重複抽樣很多次)把它找出來。儲存格 2 會把 students.csv 的 30 人當成一個小母體,實際重複抽樣給你看。
三、樣本平均數的抽樣分配與標準誤
1. x̄ 的平均數與標準差
從平均數 μ、標準差 σ 的母體中,隨機抽出 n 個獨立的觀察值,樣本平均數 x̄ 的抽樣分配滿足:
- 中心:E(x̄) = μ——x̄ 不會系統性地高估或低估 μ,稱為不偏(unbiased)。
- 離散程度:SD(x̄) = σ / √n——n 越大,x̄ 越集中在 μ 附近。
這個 σ/√n 就叫做 x̄ 的標準誤(Standard Error, SE)。
2. 標準差 vs. 標準誤
| 標準差 σ(或 s) | 標準誤 SE = σ/√n | |
|---|---|---|
| 描述什麼的變動? | 個體之間的差異 | 樣本平均數在重複抽樣下的差異 |
| 例子 | 同學之間通勤時間差多少 | 「64 人平均通勤時間」換一批人會差多少 |
| n 變大時 | 不會變小(母體本來就這麼分散) | 會變小(平均數越來越準) |
💡 √n 法則:SE 與 √n 成反比,所以樣本數變 4 倍,SE 才減半;要把誤差縮小到十分之一,樣本數得變成 100 倍。這也是為什麼民調很少做到上萬份——成本增加很多,精確度卻只改善一點點。
例:通勤時間(教學用假設)。假設全校學生的單程通勤時間平均 μ = 30 分鐘、標準差 σ = 30 分鐘(右偏,少數同學通勤很久)。
| 樣本數 n | SE = 30/√n | 意義 |
|---|---|---|
| 1 | 30 分鐘 | 只問一個人,誤差和母體一樣大 |
| 4 | 15 分鐘 | n 變 4 倍,SE 減半 |
| 16 | 7.5 分鐘 | 再變 4 倍,再減半 |
| 64 | 3.75 分鐘 | |
| 100 | 3 分鐘 |
儲存格 3 會用模擬驗證這張表。
3. 母體是常態時:x̄ 也「剛好」是常態
若母體本身就是常態分配 N(μ, σ²),則不論 n 多小,x̄ 都剛好服從 N(μ, σ²/n)。
例:手搖飲杯量抽檢(教學用假設)。某店大杯標示 700 mL,實際裝填量 ~ N(700, 15²):
- 單杯少於 690 mL 的機率:z = (690 − 700)/15 ≈ −0.67,約 25%——單杯不足很常見。
- 抽 9 杯的平均:SE = 15/√9 = 5 mL,z = (690 − 700)/5 = −2,P(x̄ < 690) 只有約 2.3%。
所以「某一杯少了 10 mL」不代表機器有問題,但「9 杯平均少了 10 mL」就很可疑了——這正是抽檢「看平均」的道理(儲存格 7)。
4. 補充:有限母體修正
上面的公式假設各觀察值獨立(取後放回,或母體遠大於樣本)。若從大小 N 的有限母體取後不放回抽 n 個,SE 要乘上有限母體修正因子 √((N − n)/(N − 1))。一般經驗是 n 不超過 N 的 5% 時,修正因子很接近 1,可以忽略;例如民調從上千萬人中抽 1,000 人,完全不需修正。
四、中央極限定理(Central Limit Theorem, CLT)
1. 定理內容
📌 中央極限定理:從任何平均數為 μ、標準差為 σ(有限)的母體中,隨機抽出 n 個獨立觀察值。當 n 夠大時,不論母體分配長什麼樣子,樣本平均數 x̄ 的抽樣分配都會近似常態分配:
x̄ ≈ N(μ, σ²/n),也就是 z = (x̄ − μ) / (σ/√n) ≈ N(0, 1)
白話來說:個體可以很「歪」,但平均數會很「正」。把很多個獨立的隨機量加起來(或平均起來),各自的偏差會互相抵銷,最後的形狀就會趨近鐘形。這也解釋了單元 3 的問題——為什麼身高、測量誤差這些「由許多小因素累加而成」的量,常常近似常態。
2. 三件事要分清楚
| 性質 | 需要什麼條件? |
|---|---|
| E(x̄) = μ | 隨機抽樣即可,任何 n 都成立 |
| SD(x̄) = σ/√n | 觀察值獨立即可,任何 n 都成立 |
| x̄ 的形狀近似常態 | 母體是常態(任何 n),或 n 夠大(CLT) |
⚠️ 中央極限定理說的是「x̄ 的分配」變常態,不是「樣本資料」變常態。你抽 1,000 位同學的通勤時間,畫出來的直方圖還是右偏的;變成鐘形的,是「很多次抽樣的 x̄」。
3. n 要多大才「夠大」?
課本常說「n ≥ 30」,但這只是經驗法則,真正需要多大,取決於母體有多偏、尾巴有多厚:
| 母體形狀 | 大約需要的 n | 例子 |
|---|---|---|
| 常態 | 任何 n | 手搖飲裝填量(教學假設) |
| 大致對稱、無極端值 | 10~15 就不錯 | 擲骰子點數 |
| 中度偏態 | 約 30 | students.csv 睡眠時數(左偏)、卜瓦松 λ = 0.7 |
| 強烈偏態 | 可能要 50~100 以上 | 指數分配(偏態 = 2)的通勤時間 |
| 極度偏態、少數極端值 | 上千都不夠 | 統一發票獎金(單元 3) |
一個好用的參考:x̄ 的偏態係數 = 母體偏態 / √n。指數分配的偏態是 2,n = 30 時 x̄ 的偏態約 2/√30 ≈ 0.37,仍看得出一點右偏;n = 100 時降到 0.2。儲存格 4~6 會用三種偏態母體實際模擬。
五、樣本比例的抽樣分配
1. p̂ 其實也是一種平均數
很多問題關心的是「比例」:支持某政策的選民比例、裝填不足的杯數比例、搭捷運通勤的學生比例。若把「是」記為 1、「否」記為 0,樣本比例 p̂ 就是這些 0/1 的平均數,所以 CLT 一樣適用:
- E(p̂) = p
- SE(p̂) = √( p(1 − p) / n )
- 當 np ≥ 10 且 n(1 − p) ≥ 10 時,p̂ ≈ N(p, p(1 − p)/n)
(單元 3 學過,n 次試驗中「是」的次數 X ~ B(n, p),而 p̂ = X/n,所以 SE = √(np(1 − p))/n = √(p(1 − p)/n)。)
2. 民調樣本數:「1,068 份、誤差 ±3%」從哪裡來?
台灣的民調報告常寫「有效樣本 1,068 份,在 95% 信心水準下,抽樣誤差為正負 3 個百分點」。這個數字的來源是:
- 常態分配中間 95% 落在 ±1.96 個標準差之內(單元 3);
- p = 0.5 時 p(1 − p) = 0.25 最大,是「最保守」的情況;
- 誤差範圍 = 1.96 × √(0.25/n) = 0.03 → n = (1.96/0.03)² × 0.25 ≈ 1,067.1,所以取 1,068 份。
| 樣本數 n | 最保守誤差 1.96 × √(0.25/n) |
|---|---|
| 100 | ±9.8% |
| 400 | ±4.9% |
| 1,068 | ±3.0% |
| 2,401 | ±2.0% |
| 9,604 | ±1.0% |
注意這個誤差和母體大小幾乎無關:不論是全台灣還是單一縣市,只要隨機抽 1,068 人,抽樣誤差都約 ±3%。決定精確度的是樣本數,不是「抽了母體的百分之幾」。
⚠️ 「±3%」只包含隨機抽樣誤差。若民調只打市話(年輕人較少接)、拒訪率高、題目有引導性,造成的偏差不會因為樣本數變大而消失。一個樣本 10 萬人的網路自填問卷,可能比 1,068 人的隨機電話民調還不準。實際民調另有抽樣設計與加權方法,本單元只談最基本的簡單隨機抽樣。
六、t 分配預告與中央極限定理的限制
1. σ 未知怎麼辦?——t 分配
前面的 z = (x̄ − μ)/(σ/√n) 需要知道母體標準差 σ,但現實中 σ 和 μ 一樣通常是未知的。很自然的做法是用樣本標準差 s 取代 σ:
t = (x̄ − μ) / (s / √n)
由於 s 本身也會隨樣本變動(尤其 n 小時),t 的分配比標準常態更分散、尾巴更厚。若母體是常態,t 剛好服從自由度 df = n − 1 的 t 分配:
| 自由度 df | 中間 95% 的臨界值 t₀.₉₇₅ | 和 z = 1.960 相比 |
|---|---|---|
| 4(n = 5) | 2.776 | 大很多 |
| 9(n = 10) | 2.262 | |
| 29(n = 30) | 2.045 | |
| 99(n = 100) | 1.984 | 已非常接近 |
df 越大,t 分配越接近標準常態。儲存格 9 會示範:n = 5 時,如果誤用 1.96,「超出 ±1.96」的機率會從 5% 變成約 12%。單元 5 的信賴區間會正式使用 t 分配。
2. 中央極限定理什麼時候會失靈?
| 情況 | 會發生什麼 | 例子 |
|---|---|---|
| n 太小,母體又很偏 | x̄ 仍明顯偏態,常態近似的機率會算錯 | 指數母體 n = 5;發票獎金連 n = 1,000 都不夠 |
| 厚尾、變異數無限大 | CLT 的前提「σ 有限」不成立,x̄ 不會越來越集中 | 柯西分配:n = 1,000 的 x̄ 和 n = 10 一樣分散 |
| 觀察值不獨立 | SE 公式 σ/√n 會低估真正的變動 | 只抽同一班、同一家族;連續幾天的通勤時間 |
| 抽樣有偏差 | x̄ 集中在錯的地方,n 越大只是越「精確地錯」 | 網路自願填答的民調 |
| 比例 p 太接近 0 或 1 | np 太小,p̂ 的分配偏態、離散 | n = 50、p = 0.02 時 np = 1 |
💡 CLT 不是魔法:它能把「形狀」修正成常態,但修正不了「偏差」與「不獨立」。使用之前先問三個問題:樣本是隨機的嗎?觀察值獨立嗎?以母體的偏態而言,n 夠大嗎?
七、Python 實作:用模擬「看見」抽樣分配
範例資料說明
本單元繼續使用單元 1~3 的 students.csv:30 位學生的「虛構」問卷資料(由程式隨機產生,非真實個資,人物與數值皆為虛構)。我們把這 30 人的 sleep_hours(睡眠時數)當成一個小母體,實際重複抽樣,觀察 x̄ 的抽樣分配;練習題會用到 drinks_per_week(每週手搖飲杯數)。通勤時間、手搖飲裝填量、民調支持率、手搖飲店來客數等例子則用教學用假設的理論分配,以 numpy 模擬。
📥 下載範例資料:students.csv | 📥 完整程式碼:unit04.py
環境準備
本單元使用的套件和單元 3 相同。Google Colab 已內建;若在自己電腦執行,請先安裝:
pip install numpy scipy pandas matplotlib
把 students.csv 和程式放在同一個資料夾(使用 Colab 的同學,請先點左側📁圖示上傳 students.csv)。下面每一個程式區塊可以當成 Notebook 的一個儲存格(cell),請依序執行——因為所有模擬共用同一個亂數產生器,跳著執行會得到不同的數字。
儲存格 1:匯入套件、設定中文字型,並把睡眠時數當成「母體」
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

# 讓圖表可以顯示繁體中文(依序嘗試 Windows / macOS / Linux 的字型)
plt.rcParams["font.sans-serif"] = [
    "Microsoft JhengHei", "PingFang TC", "Noto Sans CJK TC",
    "Noto Serif CJK TC", "Arial Unicode MS", "DejaVu Sans",
]
plt.rcParams["axes.unicode_minus"] = False  # 讓負號正常顯示

pd.set_option("display.unicode.east_asian_width", True)
pd.set_option("display.width", 160)

# 固定種子,讓每次執行的模擬結果都一樣
rng = np.random.default_rng(2026)

df = pd.read_csv("students.csv", encoding="utf-8-sig")
sleep = df["sleep_hours"].to_numpy()
N = len(sleep)
mu = sleep.mean()
sigma = sleep.std(ddof=0)          # 把 30 人當成「母體」→ 用母體標準差(除以 N)
print(f"母體大小 N = {N}")
print(f"母體平均 μ = {mu:.4f} 小時,母體標準差 σ = {sigma:.4f} 小時")
print(f"母體偏態係數 = {stats.skew(sleep):.3f}(負值代表左偏)")
執行結果:
母體大小 N = 30
母體平均 μ = 6.6867 小時,母體標準差 σ = 0.8709 小時
母體偏態係數 = -0.793(負值代表左偏)
說明:
- 這裡刻意把 30 位同學當成整個母體,所以 μ = 6.6867 小時、σ = 0.8709 小時是「已知的參數」。現實中我們不會知道母體參數;但先在「答案已知」的情況下練習,才能檢查抽樣分配的理論對不對。
- 因為是母體,標準差用
std(ddof=0)(除以 N)。單元 2、3 把這 30 人當成樣本時用的是ddof=1(除以 n − 1),得到 0.8858;兩者差異來自分母不同。 - 偏態係數 −0.793 代表左偏:大多數同學睡 6~8 小時,但有少數幾位只睡 4.5~5 小時,把左尾拉長。
儲存格 2:同一個母體,每次抽樣的 x̄ 都不一樣——抽樣分配
# 從 30 人中隨機抽 n = 5 人(取後不放回),重複 5 次,看看樣本平均數會不會一樣
n = 5
for i in range(1, 6):
    idx = rng.choice(N, size=n, replace=False)
    s = sleep[idx]
    print(f"第 {i} 次抽樣:{s} → x̄ = {s.mean():.2f},s = {s.std(ddof=1):.2f}")

# 重複抽 10,000 次,收集 10,000 個 x̄ → 這就是 x̄ 的「抽樣分配」(模擬版)
xbars = np.array([sleep[rng.choice(N, size=n, replace=False)].mean() for _ in range(10_000)])
fpc = np.sqrt((N - n) / (N - 1))   # 有限母體修正因子(取後不放回時使用)
print(f"\n10,000 個 x̄ 的平均 = {xbars.mean():.4f}(母體 μ = {mu:.4f})")
print(f"10,000 個 x̄ 的標準差 = {xbars.std():.4f}")
print(f"理論 SE = σ/√n × √((N−n)/(N−1)) = {sigma / np.sqrt(n):.4f} × {fpc:.4f} = {sigma / np.sqrt(n) * fpc:.4f}")
執行結果:
第 1 次抽樣:[6.5 6.4 7.4 4.5 6.6] → x̄ = 6.28,s = 1.07
第 2 次抽樣:[6.4 4.5 7.7 8.1 7.5] → x̄ = 6.84,s = 1.45
第 3 次抽樣:[6.7 7.4 7.2 7.  4.8] → x̄ = 6.62,s = 1.05
第 4 次抽樣:[6.6 6.4 7.9 7.7 6.5] → x̄ = 7.02,s = 0.72
第 5 次抽樣:[6.4 7.1 6.9 7.4 7.7] → x̄ = 7.10,s = 0.49

10,000 個 x̄ 的平均 = 6.6894(母體 μ = 6.6867)
10,000 個 x̄ 的標準差 = 0.3637
理論 SE = σ/√n × √((N−n)/(N−1)) = 0.3895 × 0.9285 = 0.3616
說明:
- 同樣從這 30 人中抽 5 人,5 次得到的 x̄ 從 6.28 到 7.10 都有——統計量是隨機的。第 1、2 次都剛好抽到只睡 4.5 小時的同學,x̄ 就被拉低。
- 重複 10,000 次後,10,000 個 x̄ 的平均 6.6894 幾乎等於 μ = 6.6867,驗證了 E(x̄) = μ。
- 10,000 個 x̄ 的標準差 0.3637,和理論 SE 0.3616 非常接近。因為這裡是取後不放回、而且 n = 5 占了母體 30 人的 1/6,所以要乘上有限母體修正因子 0.9285;若沒修正,σ/√n = 0.3895 會高估。
rng.choice(N, size=n, replace=False)抽出的是「第幾位同學」(索引),再用sleep[idx]取出對應的睡眠時數。
儲存格 3:標準誤——通勤時間的 σ/√n
# 通勤時間(教學假設):右偏,以指數分配近似,平均 μ = 30 分鐘、標準差 σ = 30 分鐘
mu_c, sigma_c = 30, 30
rows = []
for n in [1, 4, 16, 64, 100]:
    sample_means = rng.exponential(scale=mu_c, size=(20_000, n)).mean(axis=1)
    rows.append({"n": n,
                 "理論 SE = σ/√n": sigma_c / np.sqrt(n),
                 "模擬 x̄ 的標準差": sample_means.std(),
                 "模擬 x̄ 的平均": sample_means.mean()})
print(pd.DataFrame(rows).round(3).to_string(index=False))
執行結果:
  n  理論 SE = σ/√n  模擬 x̄ 的標準差  模擬 x̄ 的平均
  1           30.00            30.113          29.719
  4           15.00            15.007          29.802
 16            7.50             7.493          29.981
 64            3.75             3.745          29.979
100            3.00             3.018          30.009
說明:
rng.exponential(scale=30, size=(20_000, n))一次產生 20,000 列、每列 n 個通勤時間(教學假設:指數分配,μ = σ = 30 分鐘),.mean(axis=1)對每一列取平均,就得到 20,000 個 x̄。這種「一列一個樣本」的寫法比 for 迴圈快很多。- 模擬 x̄ 的標準差(30.113、15.007、7.493、3.745、3.018)和理論 SE(30、15、7.5、3.75、3)幾乎一樣:n 每變 4 倍,SE 就減半。
- 不論 n 多少,x̄ 的平均都在 30 附近,再次驗證 x̄ 是 μ 的不偏估計。
- 問 64 位同學,平均通勤時間的 SE 約 3.75 分鐘;依常態近似,x̄ 大約有 95% 的機會落在 30 ± 1.96 × 3.75,也就是約 22.7~37.3 分鐘之間。
儲存格 4:中央極限定理——從強烈右偏的指數母體出發
# 中央極限定理:指數母體(偏態 = 2)的 x̄,隨 n 增加越來越像常態
rows = []
for n in [1, 2, 5, 10, 30, 100]:
    m = rng.exponential(scale=mu_c, size=(20_000, n)).mean(axis=1)
    se = sigma_c / np.sqrt(n)
    rows.append({"n": n,
                 "x̄ 偏態(理論 2/√n)": 2 / np.sqrt(n),
                 "x̄ 偏態(模擬)": stats.skew(m),
                 "P(x̄ > μ+1.645SE) 模擬": (m > mu_c + 1.645 * se).mean(),
                 "常態近似": 0.05})
print(pd.DataFrame(rows).round(4).to_string(index=False))
執行結果:
  n  x̄ 偏態(理論 2/√n)  x̄ 偏態(模擬)  P(x̄ > μ+1.645SE) 模擬  常態近似
  1                2.0000           2.1725                  0.0700      0.05
  2                1.4142           1.3977                  0.0712      0.05
  5                0.8944           0.8442                  0.0655      0.05
 10                0.6325           0.6397                  0.0632      0.05
 30                0.3651           0.3209                  0.0582      0.05
100                0.2000           0.2163                  0.0582      0.05
說明:
- 指數分配本身的偏態係數是 2(強烈右偏)。x̄ 的偏態理論上是 2/√n:模擬值(2.17、1.40、0.84、0.64、0.32、0.22)大致跟著理論值一路下降,n = 100 時只剩約 0.2,形狀已經很接近對稱的常態。(偏態係數本身對極端值很敏感,所以模擬值會有些波動。)
- 第四欄檢查「右尾 5%」:若 x̄ 真的是常態,x̄ 超過 μ + 1.645 SE 的機率應是 0.05。n = 1 時實際是 0.0700,n = 5 是 0.0655,n = 30、100 降到 0.0582——越來越接近 0.05,但 n = 100 仍有一點偏差。母體越偏,CLT 收斂得越慢。
- 實務意義:如果通勤時間真的這麼右偏,只問 5 位同學就用常態分配算機率,誤差會比較明顯;問到 30 人以上,常態近似就相當堪用。
儲存格 5:卜瓦松母體——手搖飲店每分鐘來客數
# 手搖飲店每分鐘進店人數(教學假設)~ Poisson(0.7):離散、右偏
lam = 0.7
print("母體 P(X = k):", np.round(stats.poisson.pmf(np.arange(5), lam), 4))
print(f"母體 μ = {lam},σ = √λ = {np.sqrt(lam):.4f},偏態 = 1/√λ = {1 / np.sqrt(lam):.4f}")
for n in [5, 30, 60]:
    m = rng.poisson(lam, size=(20_000, n)).mean(axis=1)     # n 分鐘的平均進店人數
    print(f"n = {n:>2}:x̄ 平均 = {m.mean():.4f},x̄ 標準差 = {m.std():.4f}"
          f"(理論 {np.sqrt(lam / n):.4f}),偏態 = {stats.skew(m):.3f},"
          f"不同 x̄ 值的個數 = {len(np.unique(m))}")
執行結果:
母體 P(X = k): [0.4966 0.3476 0.1217 0.0284 0.005 ]
母體 μ = 0.7,σ = √λ = 0.8367,偏態 = 1/√λ = 1.1952
n =  5:x̄ 平均 = 0.6990,x̄ 標準差 = 0.3769(理論 0.3742),偏態 = 0.573,不同 x̄ 值的個數 = 14
n = 30:x̄ 平均 = 0.7002,x̄ 標準差 = 0.1529(理論 0.1528),偏態 = 0.229,不同 x̄ 值的個數 = 35
n = 60:x̄ 平均 = 0.7011,x̄ 標準差 = 0.1072(理論 0.1080),偏態 = 0.134,不同 x̄ 值的個數 = 52
說明:
- 教學假設:某手搖飲店每分鐘進店人數 ~ Poisson(0.7)。母體非常「歪」:約一半(0.4966)的分鐘沒有客人,偏態約 1.20,而且只能取 0, 1, 2, … 等整數。
- 取 n 分鐘的平均來客數:x̄ 的標準差 0.3769、0.1529、0.1072,都和理論 √(λ/n) 吻合;偏態從 0.573(n = 5)降到 0.229(n = 30)、0.134(n = 60),越來越對稱。
- 「不同 x̄ 值的個數」顯示另一個現象:n = 5 時 x̄ 只有 14 種可能的值(0、0.2、0.4…),分配是一格一格的;n = 60 時有 52 種值,看起來就像連續的鐘形。離散的母體,x̄ 也會隨 n 變大而變得「平滑」。
儲存格 6:真實資料版——students.csv 睡眠時數的 x̄
# students.csv 睡眠時數:把 30 人當母體,取後放回抽 n 人,看 x̄ 的分配
rows = []
for n in [1, 2, 5, 15, 30]:
    m = rng.choice(sleep, size=(20_000, n), replace=True).mean(axis=1)
    lo, hi = np.percentile(m, [2.5, 97.5])
    rows.append({"n": n, "x̄ 平均": m.mean(), "x̄ 標準差": m.std(),
                 "理論 σ/√n": sigma / np.sqrt(n), "x̄ 偏態": stats.skew(m),
                 "中間 95% 下限": lo, "中間 95% 上限": hi})
print(pd.DataFrame(rows).round(4).to_string(index=False))
print(f"\n母體 μ ± 1.96σ/√30 = [{mu - 1.96 * sigma / np.sqrt(30):.4f}, {mu + 1.96 * sigma / np.sqrt(30):.4f}]")
執行結果:
 n  x̄ 平均  x̄ 標準差  理論 σ/√n  x̄ 偏態  中間 95% 下限  中間 95% 上限
 1   6.6815     0.8735     0.8709  -0.8071         4.5000         8.1000
 2   6.6895     0.6167     0.6158  -0.5803         5.4000         7.7000
 5   6.6833     0.3895     0.3895  -0.3415         5.8600         7.3600
15   6.6897     0.2253     0.2249  -0.2131         6.2267         7.1133
30   6.6872     0.1593     0.1590  -0.1175         6.3700         6.9867

母體 μ ± 1.96σ/√30 = [6.3750, 6.9983]
說明:
- 這次用
replace=True(取後放回),每次抽取互相獨立,所以 SE 直接就是 σ/√n,不需有限母體修正:模擬的 x̄ 標準差(0.8735、0.6167、0.3895、0.2253、0.1593)和理論值(0.8709、0.6158、0.3895、0.2249、0.1590)幾乎一模一樣。 - 母體左偏(偏態約 −0.81),x̄ 的偏態隨 n 增加一路往 0 靠近:n = 30 時只剩 −0.12,已相當對稱。
- n = 30 時,模擬出的「中間 95%」是 [6.37, 6.99],和常態近似 μ ± 1.96 σ/√30 = [6.375, 6.998] 幾乎重疊——就算不知道母體長什麼樣子,也能用常態分配描述 x̄,這就是 CLT 的威力。
- 注意 n = 1 時的「x̄」其實就是單一個人,所以中間 95% 是 [4.5, 8.1],和母體一樣寬。
儲存格 7:手搖飲杯量抽檢——母體是常態時的 x̄
# 手搖飲杯量抽檢(教學假設):標示 700 mL,實際裝填量 ~ N(700, 15²)
fill_mu, fill_sd = 700, 15
one = stats.norm(fill_mu, fill_sd)
print(f"單杯少於 690 mL 的機率:{one.cdf(690):.4f}")
for n in [4, 9, 25]:
    se = fill_sd / np.sqrt(n)
    print(f"抽 {n:>2} 杯:SE = {se:.2f} mL,P(x̄ < 690) = {stats.norm.cdf(690, fill_mu, se):.6f}")

# 若機器偏移,平均只剩 692 mL:抽 9 杯,x̄ < 695 就判定「需要校正」,抓到的機率?
se9 = fill_sd / np.sqrt(9)
print(f"\n正常機器(μ=700) 被誤判的機率 P(x̄ < 695) = {stats.norm.cdf(695, 700, se9):.4f}")
print(f"偏移機器(μ=692) 被抓到的機率 P(x̄ < 695) = {stats.norm.cdf(695, 692, se9):.4f}")
執行結果:
單杯少於 690 mL 的機率:0.2525
抽  4 杯:SE = 7.50 mL,P(x̄ < 690) = 0.091211
抽  9 杯:SE = 5.00 mL,P(x̄ < 690) = 0.022750
抽 25 杯:SE = 3.00 mL,P(x̄ < 690) = 0.000429

正常機器(μ=700) 被誤判的機率 P(x̄ < 695) = 0.1587
偏移機器(μ=692) 被抓到的機率 P(x̄ < 695) = 0.7257
說明:
- 教學假設:裝填量 ~ N(700, 15²)。單杯少於 690 mL 的機率約 25%;但 9 杯平均少於 690 mL 的機率只有 0.0228,25 杯更只有 0.0004。看平均比看單杯可靠得多。
- 母體是常態,所以這些機率是精確值,不需要 CLT 的「n 夠大」。
- 後半段是一個簡單的「品管規則」:抽 9 杯,x̄ < 695 mL 就判定機器需要校正。正常機器(μ = 700)被誤判的機率約 0.1587;若機器偏移到 μ = 692,被抓到的機率約 0.7257。誤判與漏抓之間的取捨,正是之後「假設檢定」的型 I、型 II 錯誤。
stats.norm.cdf(690, 700, se)的第三個參數要放 SE(x̄ 的標準差),而不是單杯的 σ = 15——這是本單元最常見的錯誤。
儲存格 8:樣本比例——民調樣本數與誤差範圍
# 民調(教學假設):全體選民中支持某政策的真實比例 p = 0.42
p_true = 0.42
for n in [100, 400, 1068, 2000]:
    p_hat = rng.binomial(n, p_true, size=20_000) / n       # 2 萬次民調的 p̂
    se = np.sqrt(p_true * (1 - p_true) / n)
    print(f"n = {n:>4}:理論 SE = {se:.4f},模擬 SD(p̂) = {p_hat.std():.4f},"
          f"1.96×SE = ±{1.96 * se:.2%},p̂ 落在 p ± 1.96SE 的比例 = {(abs(p_hat - p_true) <= 1.96 * se).mean():.4f}")

# 最保守(p = 0.5)的誤差範圍:為什麼民調常說「1,068 份、誤差 ±3%」
print(f"\np = 0.5、n = 1068:1.96 × √(0.25/1068) = ±{1.96 * np.sqrt(0.25 / 1068):.2%}")
print(f"要誤差 ±3%,最少樣本數 = (1.96/0.03)² × 0.25 = {(1.96 / 0.03) ** 2 * 0.25:.1f}")

# 檢查常態近似的條件 np ≥ 10 且 n(1−p) ≥ 10
for n, p in [(1068, 0.42), (50, 0.02)]:
    print(f"n = {n}, p = {p}:np = {n * p:.1f},n(1−p) = {n * (1 - p):.1f}")
執行結果:
n =  100:理論 SE = 0.0494,模擬 SD(p̂) = 0.0494,1.96×SE = ±9.67%,p̂ 落在 p ± 1.96SE 的比例 = 0.9486
n =  400:理論 SE = 0.0247,模擬 SD(p̂) = 0.0246,1.96×SE = ±4.84%,p̂ 落在 p ± 1.96SE 的比例 = 0.9528
n = 1068:理論 SE = 0.0151,模擬 SD(p̂) = 0.0151,1.96×SE = ±2.96%,p̂ 落在 p ± 1.96SE 的比例 = 0.9519
n = 2000:理論 SE = 0.0110,模擬 SD(p̂) = 0.0110,1.96×SE = ±2.16%,p̂ 落在 p ± 1.96SE 的比例 = 0.9528

p = 0.5、n = 1068:1.96 × √(0.25/1068) = ±3.00%
要誤差 ±3%,最少樣本數 = (1.96/0.03)² × 0.25 = 1067.1
n = 1068, p = 0.42:np = 448.6,n(1−p) = 619.4
n = 50, p = 0.02:np = 1.0,n(1−p) = 49.0
說明:
- 教學假設:真實支持率 p = 0.42。
rng.binomial(n, p, size=20_000) / n一次模擬 2 萬次民調,每次得到一個 p̂。 - 模擬的 SD(p̂) 和理論 √(p(1 − p)/n) 完全吻合;不論 n = 100 或 2,000,p̂ 落在 p ± 1.96 SE 內的比例都約 95%(0.9486~0.9528),說明常態近似對比例很好用。
- n = 1,068 時,p = 0.42 的誤差約 ±2.96%;用最保守的 p = 0.5 算則剛好是 ±3.00%,反推所需樣本數 1,067.1,無條件進位就是民調常見的 1,068 份。
- 條件檢查:n = 1,068、p = 0.42 時 np ≈ 449,遠大於 10;但若 n = 50、p = 0.02(例如調查罕見的特徵),np 只有 1,常態近似不適用,此時應直接用二項分配計算。
儲存格 9:t 分配預告——用 s 取代 σ 的代價
# t 分配預告:σ 未知、改用樣本標準差 s 時,標準化後的 x̄ 不再是標準常態
n, reps = 5, 50_000
x = rng.normal(fill_mu, fill_sd, size=(reps, n))      # 每次抽 5 杯
xbar = x.mean(axis=1)
s = x.std(axis=1, ddof=1)
z_stat = (xbar - fill_mu) / (fill_sd / np.sqrt(n))    # 用真正的 σ
t_stat = (xbar - fill_mu) / (s / np.sqrt(n))          # 用樣本的 s
print(f"n = {n}:|z| > 1.96 的比例 = {(abs(z_stat) > 1.96).mean():.4f}")
print(f"n = {n}:|t| > 1.96 的比例 = {(abs(t_stat) > 1.96).mean():.4f}")
print(f"t({n - 1}) 理論 P(|T| > 1.96) = {2 * stats.t.sf(1.96, n - 1):.4f}")
print()
for d in [4, 9, 29, 99]:
    print(f"自由度 df = {d:>2}:t 分配中間 95% 的臨界值 = {stats.t.ppf(0.975, d):.3f}(常態為 1.960)")
執行結果:
n = 5:|z| > 1.96 的比例 = 0.0496
n = 5:|t| > 1.96 的比例 = 0.1200
t(4) 理論 P(|T| > 1.96) = 0.1216

自由度 df =  4:t 分配中間 95% 的臨界值 = 2.776(常態為 1.960)
自由度 df =  9:t 分配中間 95% 的臨界值 = 2.262(常態為 1.960)
自由度 df = 29:t 分配中間 95% 的臨界值 = 2.045(常態為 1.960)
自由度 df = 99:t 分配中間 95% 的臨界值 = 1.984(常態為 1.960)
說明:
- 每次從 N(700, 15²) 抽 5 杯,分別用真正的 σ 和樣本的 s 標準化。用 σ 時,|z| > 1.96 的比例是 0.0496,正好約 5%;改用 s 時,|t| > 1.96 的比例變成 0.1200,是兩倍多!
- 這和 t(4) 分配的理論值 0.1216 非常接近:n 小時 s 不穩定,有時會低估 σ,使 t 值變得很大,所以 t 分配的尾巴比常態厚。
- 因此 n = 5 時,要用 t 分配的臨界值 2.776 而不是 1.96;df = 29 時是 2.045,df = 99 時 1.984,已經很接近 1.96。單元 5 會用
stats.t.ppf()建立信賴區間。
儲存格 10:中央極限定理什麼時候會失靈?
# (a) 小 n + 嚴重偏態:發票獎金(單元 3),抽 1,000 張的平均獎金
prize = np.array([10_000_000, 2_000_000, 200_000, 40_000, 10_000, 4_000, 1_000, 200, 0])
prob = np.array([1, 1, 3, 27, 270, 2_700, 27_000, 270_000, 0]) / 1e8
prob[-1] = 1 - prob.sum()
inv_means = np.array([rng.choice(prize, size=1_000, p=prob).mean() for _ in range(5_000)])
print(f"(a) 1,000 張發票的平均獎金:偏態 = {stats.skew(inv_means):.2f},"
      f"中位數 = {np.median(inv_means):.2f} 元,平均 = {inv_means.mean():.2f} 元(理論 1.08 元)")

# (b) 厚尾:柯西分配(Cauchy)沒有平均數與變異數,n 再大,x̄ 也不會集中
for n in [10, 100, 1_000]:
    m = rng.standard_cauchy(size=(5_000, n)).mean(axis=1)
    q1, q3 = np.percentile(m, [25, 75])
    print(f"(b) 柯西 n = {n:>5}:x̄ 的四分位距 IQR = {q3 - q1:.3f},最大 |x̄| = {np.abs(m).max():,.1f}")
for n in [10, 100, 1_000]:
    m = rng.normal(0, 1, size=(5_000, n)).mean(axis=1)
    q1, q3 = np.percentile(m, [25, 75])
    print(f"    常態 n = {n:>5}:x̄ 的四分位距 IQR = {q3 - q1:.3f}")
執行結果:
(a) 1,000 張發票的平均獎金:偏態 = 9.97,中位數 = 0.60 元,平均 = 0.96 元(理論 1.08 元)
(b) 柯西 n =    10:x̄ 的四分位距 IQR = 2.036,最大 |x̄| = 63,885.7
(b) 柯西 n =   100:x̄ 的四分位距 IQR = 1.979,最大 |x̄| = 2,169.2
(b) 柯西 n =  1000:x̄ 的四分位距 IQR = 1.939,最大 |x̄| = 5,357.7
    常態 n =    10:x̄ 的四分位距 IQR = 0.431
    常態 n =   100:x̄ 的四分位距 IQR = 0.137
    常態 n =  1000:x̄ 的四分位距 IQR = 0.043
說明:
- (a) 單元 3 的統一發票獎金極度右偏(絕大多數 0 元,極少數千萬元)。就算每次平均 1,000 張,5,000 個 x̄ 的偏態仍高達約 9.97,中位數 0.60 元遠低於平均 0.96 元——n = 1,000 都還不夠讓 x̄ 變常態。「n ≥ 30」的經驗法則在這裡完全不適用。(模擬平均 0.96 元低於理論 1.08 元,是因為 5,000 × 1,000 = 500 萬張中,特別獎、特獎這種 1/10⁸ 機率的大獎通常一張都抽不到。)
- (b) 柯西分配是一種尾巴非常厚的對稱分配,它的平均數與變異數都不存在,不符合 CLT「σ 有限」的前提。結果:n = 10、100、1,000 時,x̄ 的四分位距都約 2(2.036、1.979、1.939),完全沒有變窄,而且偶爾會出現上千、上萬的極端 x̄。
- 對照組:常態母體的 x̄ 四分位距從 0.431 → 0.137 → 0.043,每次 n 變 10 倍就縮小約 √10 ≈ 3.16 倍,這才是 σ/√n 該有的樣子。
- 實務上,所得、房價、保險理賠、社群貼文的按讚數等資料常有很厚的尾巴,分析它們的平均數時要特別小心,可以考慮改看中位數或先取對數。
儲存格 11:畫出抽樣分配
XB, PH = r"$\bar{x}$", r"$\hat{p}$"   # 用 matplotlib 數學符號顯示 x̄ 與 p̂
fig, axes = plt.subplots(2, 3, figsize=(15, 8.5))

# 上排:指數母體(通勤時間,教學假設)→ n = 1、5、30 的 x̄ 抽樣分配
for ax, n, color in zip(axes[0], [1, 5, 30], ["#8DA0CB", "#4C72B0", "#1A4E80"]):
    m = rng.exponential(scale=mu_c, size=(20_000, n)).mean(axis=1)
    ax.hist(m, bins=60, density=True, color=color, edgecolor="white")
    se = sigma_c / np.sqrt(n)
    xs = np.linspace(m.min(), m.max(), 300)
    ax.plot(xs, stats.norm.pdf(xs, mu_c, se), color="#C44E52", lw=2, label=f"N({mu_c}, {se:.2f}²)")
    ax.set_title(f"指數母體(μ = σ = 30 分):n = {n} 的 {XB} 分配\n偏態 = {stats.skew(m):.2f}")
    ax.set_xlabel(f"樣本平均通勤時間 {XB}(分鐘)")
    ax.set_ylabel("密度")
    ax.legend(fontsize=9)

# 左下:睡眠時數母體 vs. n = 30 的 x̄
m_sleep = rng.choice(sleep, size=(20_000, 30), replace=True).mean(axis=1)
axes[1, 0].hist(sleep, bins=8, density=True, color="#CCCCCC", edgecolor="white", label="母體:30 人睡眠時數")
axes[1, 0].hist(m_sleep, bins=40, density=True, color="#55A868", alpha=0.8, label=f"n = 30 的 {XB}")
axes[1, 0].axvline(mu, color="black", linestyle="--", label=f"μ = {mu:.2f}")
axes[1, 0].set_title("左偏的睡眠時數 → " + XB + " 變得對稱又集中")
axes[1, 0].set_xlabel("睡眠時數(小時)")
axes[1, 0].set_ylabel("密度")
axes[1, 0].legend(fontsize=9)

# 中下:民調 n = 1068 的 p̂ 抽樣分配
n_poll = 1068
p_hat = rng.binomial(n_poll, p_true, size=20_000) / n_poll
se_p = np.sqrt(p_true * (1 - p_true) / n_poll)
axes[1, 1].hist(p_hat, bins=40, density=True, color="#FFD966", edgecolor="white", label=f"2 萬次民調的 {PH}")
xs = np.linspace(p_hat.min(), p_hat.max(), 300)
axes[1, 1].plot(xs, stats.norm.pdf(xs, p_true, se_p), color="#C44E52", lw=2, label=f"N(0.42, {se_p:.4f}²)")
for v in [p_true - 1.96 * se_p, p_true + 1.96 * se_p]:
    axes[1, 1].axvline(v, color="gray", linestyle="--")
axes[1, 1].set_title(f"民調 n = {n_poll}:{PH} 的抽樣分配(虛線為 p ± 1.96SE)")
axes[1, 1].set_xlabel(f"樣本支持率 {PH}")
axes[1, 1].set_ylabel("密度")
axes[1, 1].legend(fontsize=9)

# 右下:t 分配 vs. 標準常態
zs = np.linspace(-5, 5, 400)
axes[1, 2].plot(zs, stats.norm.pdf(zs), color="black", lw=2, label="標準常態 N(0, 1)")
axes[1, 2].plot(zs, stats.t.pdf(zs, 4), color="#C44E52", lw=2, linestyle="--", label="t 分配 df = 4")
axes[1, 2].plot(zs, stats.t.pdf(zs, 29), color="#4C72B0", lw=1.5, linestyle=":", label="t 分配 df = 29")
axes[1, 2].set_title("t 分配:中間較矮、尾巴較厚")
axes[1, 2].set_xlabel("t 或 z")
axes[1, 2].set_ylabel("密度")
axes[1, 2].legend(fontsize=9)

plt.tight_layout()
plt.savefig("unit04_charts.png", dpi=120)
plt.show()
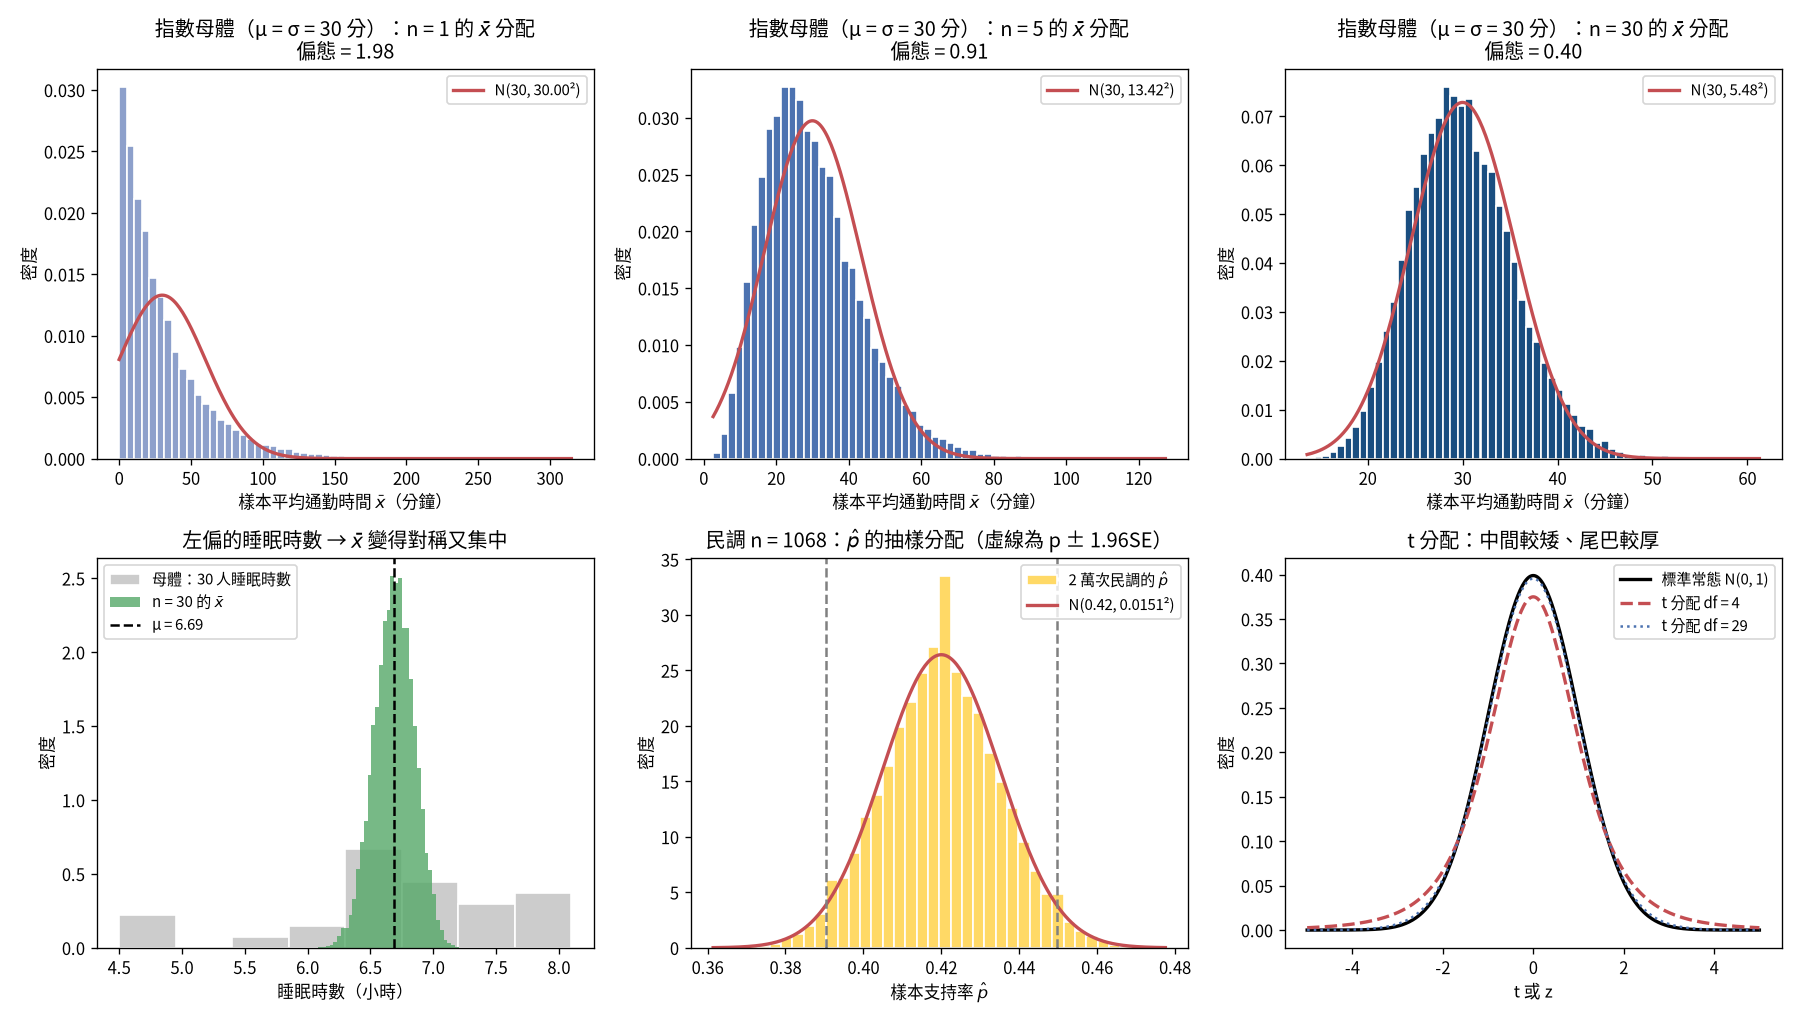
說明:
- 上排三張(中央極限定理):同一個強烈右偏的指數母體(通勤時間,教學假設)。n = 1 時就是母體本身,紅色常態曲線完全對不上;n = 5 時已經有個「峰」,但右尾仍長;n = 30 時長條與常態曲線大致吻合,只剩一點點右偏。也請注意橫軸範圍越來越窄——這就是 SE = σ/√n 變小。
- 左下(真實資料):灰色是 30 人睡眠時數的母體直方圖,左偏且凹凸不平;綠色是 n = 30 的 x̄,集中在 μ = 6.69 附近、左右對稱,寬度大約只有母體的 1/√30。
- 中下(樣本比例):2 萬次 n = 1,068 民調的 p̂ 與常態曲線幾乎完全重合;兩條灰色虛線是 p ± 1.96 SE(約 0.39~0.45),大約 95% 的民調結果落在其中。
- 右下(t 分配):df = 4 的 t 分配(紅色虛線)中間較矮、兩側尾巴明顯較厚;df = 29(藍色點線)已經和標準常態(黑線)幾乎分不出來。
八、本單元重點整理
- 參數(μ、σ、p)描述母體,固定但未知;統計量(x̄、s、p̂)由樣本算出,會隨樣本改變。
- 抽樣分配是「統計量在所有可能樣本下」的分配,不同於母體分配與樣本資料分配。
- x̄ 的抽樣分配:E(x̄) = μ(不偏),SE = σ/√n;n 變 4 倍,SE 才減半。取後不放回且 n 超過 N 的 5% 時,要乘有限母體修正因子。
- 標準差 vs. 標準誤:標準差描述個體差異,不會因 n 變大而變小;標準誤描述 x̄ 的變動,隨 n 變大而變小。
- 母體是常態 → x̄ 剛好是常態(任何 n);母體不是常態 → 靠 中央極限定理,n 夠大時 x̄ ≈ N(μ, σ²/n)。
- n 要多大取決於母體的偏態與尾巴:中度偏態約 30;強烈偏態要更多;發票獎金這種極端分配上千都不夠。x̄ 的偏態約為母體偏態/√n。
- 樣本比例:E(p̂) = p,SE = √(p(1 − p)/n);np ≥ 10 且 n(1 − p) ≥ 10 時可用常態近似。民調「1,068 份、誤差 ±3%」= 1.96 × √(0.25/1068)。
- t 分配:σ 未知、改用 s 時,(x̄ − μ)/(s/√n) 服從 df = n − 1 的 t 分配,尾巴比常態厚;df 越大越接近常態。
- CLT 會失靈:n 太小又嚴重偏態、厚尾(柯西分配)、資料不獨立、抽樣有偏差。CLT 修正形狀,修正不了偏差。
- numpy 模擬技巧:
rng.xxx(size=(重複次數, n)).mean(axis=1)一次產生大量 x̄;rng.choice(資料, size=..., replace=True/False)從真實資料重複抽樣。
九、課後練習
第 1 題|標準誤與中央極限定理:通勤時間
(教學用假設)某大學學生的單程通勤時間平均 μ = 40 分鐘、標準差 σ = 12 分鐘,分配略為右偏。隨機抽出 36 位學生:
(a) 樣本平均通勤時間 x̄ 的標準誤是多少?
(b) 用中央極限定理估計 P(x̄ > 43 分鐘)。
(c) 若希望標準誤不超過 1 分鐘,至少要抽多少人?
第 2 題|民調樣本數
某民調公司想在 95% 信心水準下(使用 1.96),以最保守的 p = 0.5 規劃樣本數:
(a) 誤差範圍要控制在 ±3%、±2%、±1%,各需要多少樣本?
(b) 從 ±2% 改善到 ±1%,樣本數變成幾倍?為什麼?
(c) 若某次民調 n = 1,068、樣本支持率為 42%,用 p̂ = 0.42 計算的誤差範圍是多少?
第 3 題|手搖飲杯量抽檢
(教學用假設)某店中杯標示 500 mL,實際裝填量 ~ N(505, 8²)。
(a) 隨機抽 1 杯,裝填量少於 500 mL 的機率是多少?
(b) 隨機抽 16 杯,平均裝填量少於 500 mL 的機率是多少?
(c) 16 杯平均的「中間 95%」範圍為何?如果稽查時 16 杯平均只有 498 mL,你會怎麼解讀?
第 4 題|numpy 模擬:每週手搖飲杯數
把 students.csv 的 30 位同學當成母體,變數為 drinks_per_week(每週喝幾杯手搖飲)。請用 np.random.default_rng(4),分別以 n = 10 與 n = 40 取後放回抽樣 10,000 次:
(a) 比較 x̄ 的平均與母體 μ、x̄ 的標準差與 σ/√n(σ 用 ddof=0)。
(b) 估計 P(x̄ ≥ 3.5),並說明為什麼 n = 40 時這個機率小很多。
第 5 題|觀念題:中央極限定理適用嗎?
判斷下列情況中,用「x̄ 近似常態」來計算機率是否合理,並說明理由:
(a) 從常態母體抽 n = 4,計算 x̄ 的機率。
(b) 某捷運站每小時遺失物件數 ~ Poisson(2),記錄 200 個小時,計算平均每小時件數的機率。
(c) 調查 8 位同學的「家庭年所得」,用常態分配算平均所得超過某個值的機率。
(d) 在 Facebook 社團貼問卷,回收 5,000 份,用 SE = √(p̂(1 − p̂)/n) 宣稱誤差只有 ±1.4%。
(e) 從柯西分配抽 n = 500,用 x̄ 估計分配的中心。
十、練習題參考答案
📝 建議先自己作答,再對照答案喔!
第 1 題
import numpy as np
from scipy import stats

mu, sigma, n = 40, 12, 36
se = sigma / np.sqrt(n)
print(f"(a) SE = {sigma} / √{n} = {se:.2f} 分鐘")
print(f"(b) P(x̄ > 43) ≈ {stats.norm.sf(43, mu, se):.4f}")
print(f"(c) 要 SE ≤ 1 分鐘,n ≥ (σ / 1)² = {(sigma / 1) ** 2:.0f}")
執行結果:
(a) SE = 12 / √36 = 2.00 分鐘
(b) P(x̄ > 43) ≈ 0.0668
(c) 要 SE ≤ 1 分鐘,n ≥ (σ / 1)² = 144
(a) SE = σ/√n = 12/√36 = 2 分鐘。
(b) n = 36 夠大、母體只是略為右偏,依 CLT x̄ ≈ N(40, 2²)。z = (43 − 40)/2 = 1.5,P(x̄ > 43) ≈ 0.0668,大約 6.7%。
(c) 12/√n ≤ 1 → √n ≥ 12 → n ≥ 144 人。SE 從 2 分鐘降到 1 分鐘(減半),樣本數要變成 4 倍(36 → 144)。
第 2 題
import numpy as np

for e in [0.03, 0.02, 0.01]:
    n_need = (1.96 / e) ** 2 * 0.25
    print(f"誤差 ±{e:.0%}:n ≥ {n_need:,.1f} → 至少 {int(np.ceil(n_need)):,} 人")
print(f"p̂ = 0.42、n = 1068 的 1.96 × SE = ±{1.96 * np.sqrt(0.42 * 0.58 / 1068):.2%}")
執行結果:
誤差 ±3%:n ≥ 1,067.1 → 至少 1,068 人
誤差 ±2%:n ≥ 2,401.0 → 至少 2,401 人
誤差 ±1%:n ≥ 9,604.0 → 至少 9,604 人
p̂ = 0.42、n = 1068 的 1.96 × SE = ±2.96%
(a) n = (1.96/E)² × 0.25:±3% 需 1,068 人、±2% 需 2,401 人、±1% 需 9,604 人。
(b) 2,401 → 9,604,正好 4 倍:誤差和 √n 成反比,誤差減半,樣本數就要變 4 倍。
(c) 1.96 × √(0.42 × 0.58/1068) ≈ ±2.96%,比最保守的 ±3% 略小——p 離 0.5 越遠,p(1 − p) 越小。
第 3 題
from scipy import stats

mu, sd = 505, 8
print(f"(a) 單杯 P(X < 500) = {stats.norm.cdf(500, mu, sd):.4f}")
se = sd / 16 ** 0.5
print(f"(b) 16 杯 SE = {se:.1f},P(x̄ < 500) = {stats.norm.cdf(500, mu, se):.4f}")
print(f"(c) 16 杯平均的中間 95% 範圍 = [{mu - 1.96 * se:.2f}, {mu + 1.96 * se:.2f}] mL")
執行結果:
(a) 單杯 P(X < 500) = 0.2660
(b) 16 杯 SE = 2.0,P(x̄ < 500) = 0.0062
(c) 16 杯平均的中間 95% 範圍 = [501.08, 508.92] mL
(a) z = (500 − 505)/8 = −0.625,P(X < 500) ≈ 0.266:單杯不足 500 mL 的情況約四分之一,很常見。
(b) SE = 8/√16 = 2 mL,z = (500 − 505)/2 = −2.5,P(x̄ < 500) ≈ 0.0062,不到 1%。
(c) 中間 95% 約為 501.08~508.92 mL。若 16 杯平均只有 498 mL,在「μ = 505」的假設下這幾乎不可能發生(比 500 還低,機率小於 0.6%),比較合理的解讀是機器的平均裝填量其實低於 505 mL,應該檢查校正。這種「如果假設成立,觀察到這種結果的機率很小,所以懷疑假設」的推理,就是之後假設檢定的核心。
第 4 題
import numpy as np
import pandas as pd
from scipy import stats

df4 = pd.read_csv("students.csv", encoding="utf-8-sig")
drinks = df4["drinks_per_week"].to_numpy()
mu4, sigma4 = drinks.mean(), drinks.std(ddof=0)
rng4 = np.random.default_rng(4)
for n in [10, 40]:
    m = rng4.choice(drinks, size=(10_000, n), replace=True).mean(axis=1)
    print(f"n = {n}:x̄ 平均 = {m.mean():.4f}(μ = {mu4:.4f}),"
          f"x̄ 標準差 = {m.std():.4f}(σ/√n = {sigma4 / np.sqrt(n):.4f}),"
          f"P(x̄ ≥ 3.5) = {(m >= 3.5).mean():.4f}")
執行結果:
n = 10:x̄ 平均 = 2.8567(μ = 2.8667),x̄ 標準差 = 0.6578(σ/√n = 0.6518),P(x̄ ≥ 3.5) = 0.1852
n = 40:x̄ 平均 = 2.8714(μ = 2.8667),x̄ 標準差 = 0.3246(σ/√n = 0.3259),P(x̄ ≥ 3.5) = 0.0292
(a) 兩種 n 之下,x̄ 的平均(2.8567、2.8714)都非常接近 μ = 2.8667;x̄ 的標準差(0.6578、0.3246)也和 σ/√n(0.6518、0.3259)吻合。n 從 10 變成 40(4 倍),標準差大約減半。
(b) n = 10 時 P(x̄ ≥ 3.5) 約 0.185,n = 40 時只剩約 0.029。3.5 杯比 μ 高了約 0.63 杯:n = 10 時這大約是 1 個 SE,相當常見;n = 40 時大約是 2 個 SE,就少見多了。樣本越大,x̄ 越不容易偏離 μ。
第 5 題
(a) 合理。母體是常態時,x̄ 對任何 n 都剛好是常態,n = 4 也沒問題。
(b) 合理。Poisson(2) 的偏態約 1/√2 ≈ 0.71,只是中度右偏;n = 200 很大,x̄ 的偏態約 0.05,常態近似非常好(前提是各小時之間大致獨立)。
(c) 不合理。所得通常強烈右偏、有極端高所得,n = 8 太小,x̄ 仍會明顯右偏;用常態算機率可能誤差很大。可以改看中位數,或蒐集更多樣本。
(d) 不合理。1.96 × √(0.25/5000) ≈ 1.4% 只計算了「隨機抽樣誤差」,但社團自願填答不是隨機樣本,填答者與一般母體可能有系統性差異(偏差),CLT 與 SE 公式都修正不了偏差。樣本再大,也只是「精確地錯」。
(e) 不合理。柯西分配的平均數與變異數都不存在,x̄ 不會隨 n 增加而集中(儲存格 10),n = 500 的 x̄ 和單一觀察值一樣分散。應改用中位數估計它的中心。
💡 小技巧:遇到「這個情況能不能用常態近似?」的問題,先用 numpy 模擬一次抽樣分配、畫出直方圖,看看形狀再決定。這比死記「n ≥ 30」可靠得多。
下一單元預告
本單元我們站在「已知母體」的角度,問「x̄ 會落在哪裡?」。但真實世界剛好相反:我們只有一個樣本的 x̄,想反過來推論未知的 μ 落在哪裡。既然 x̄ 大約有 95% 的機會落在 μ ± 1.96 SE 之內,那麼「x̄ ± 1.96 SE」這個區間,是不是也大約有 95% 的機會涵蓋 μ?單元 5 將從抽樣分配出發,帶你建立平均數與比例的信賴區間,正式使用 t 分配,並說清楚「95% 信心水準」到底是什麼意思。
© SuhsiungAI學習教室(suhsiung.com)・統計應用課程・授課教師:蘇志雄。本單元範例資料 students.csv 為教學用虛構資料,與任何真實人物無關;通勤時間、手搖飲裝填量與來客數、民調支持率等例子中的數字,除另有說明外,皆為教學用假設或簡化,不代表任何真實店家、機構或民調結果。