統計應用|單元 1:統計是什麼——資料類型、母體與樣本
SuhsiungAI學習教室 授課教師:蘇志雄
適用對象:大學部・統計初學者 實作工具:Python(pandas、matplotlib)
預估學習時間:講義閱讀 60 分鐘+實作 60 分鐘
本單元學習目標
完成本單元後,你將能夠:
- 用自己的話說明「統計」是什麼,以及它在日常生活與職場中的用途。
- 區分敘述統計與推論統計,並判斷一段新聞或報告屬於哪一種。
- 正確說出母體、樣本、參數、統計量的意義,並在實際案例中指認出來。
- 判斷一個變數屬於名目、順序、區間或比率尺度,以及它是離散或連續。
- 認識常見的抽樣方法(簡單隨機、系統、分層、集群、便利抽樣),並指出可能的偏誤。
- 使用 Python 的 pandas 讀入 CSV 資料、檢查欄位型別,並為變數標註正確的資料類型。
一、統計是什麼?
統計(Statistics)是一門「蒐集、整理、分析、解釋資料,並在不確定的情況下做出合理判斷」的學問。
聽起來很抽象?其實你每天都在接觸統計:
- 🌧️ 中央氣象署說「明天降雨機率 70%」——這是根據大量歷史資料與模型算出來的機率。
- 🗳️ 選舉前新聞報導「某候選人支持度 42%,抽樣誤差 ±3 個百分點」——這是用一千多人的電話訪問,推估全台選民的想法。
- 🧋 手搖飲店發現「週五下午半糖少冰賣最好」——這是整理銷售紀錄後得到的結論。
- 🏥 健保署分析就醫資料,掌握流感何時開始流行——這是用資料做公共衛生決策。
統計的工作流程大致可以分成四步:
| 步驟 | 要做的事 | 生活例子:「大學生睡得夠嗎?」 |
|---|---|---|
| 1. 提出問題 | 想知道什麼? | 本校大學生平均每天睡幾小時? |
| 2. 蒐集資料 | 問卷、實驗、資料庫 | 發放線上問卷給部分同學 |
| 3. 整理與分析 | 表格、圖形、計算 | 計算平均數、畫直方圖 |
| 4. 解釋與決策 | 得出結論並說明限制 | 「平均約 6.7 小時,低於建議的 7 小時」 |
💡 重點觀念:統計不只是「算數字」,更重要的是問對問題、用對資料、做出合理的解釋。
二、敘述統計 vs. 推論統計
統計大致分成兩大類:
1. 敘述統計(Descriptive Statistics)
把手上已有的資料「整理、摘要、呈現」出來,讓人一眼看懂。常用工具包括平均數、中位數、百分比、長條圖、直方圖等。
- 例:「本班 30 位同學中,有 11 位騎機車通勤,占 36.7%。」
- 例:「這學期期中考全班平均 72 分,最高 98 分。」
敘述統計只描述這批資料本身,不往外推論。
2. 推論統計(Inferential Statistics)
用一部分資料(樣本)去推估或檢驗整體(母體)的情況,並且說明這個推論有多大的不確定性。
- 例:「隨機訪問 1,068 位全台 20 歲以上民眾,推估全國支持度約 42%(95% 信心水準,誤差 ±3%)。」
- 例:「抽查 200 瓶市售礦泉水,推論該品牌整批產品是否符合標準。」
| 比較項目 | 敘述統計 | 推論統計 |
|---|---|---|
| 目的 | 描述手上的資料 | 由樣本推論母體 |
| 是否有不確定性 | 沒有(資料就是這樣) | 有(需要說明誤差或機率) |
| 常見工具 | 平均數、百分比、圖表 | 信賴區間、假設檢定、迴歸 |
| 本課程單元 | 單元 2 | 單元 4~9 |
💡 判斷小訣竅:看到「推估」、「全國」、「信心水準」、「誤差」、「顯著」等字眼,通常是推論統計。
三、母體、樣本、參數與統計量
這四個名詞是整門課的基礎,請務必弄清楚。
| 名詞 | 定義 | 常用符號 | 例子:「全台大學生每天平均睡眠時數」 |
|---|---|---|---|
| 母體(Population) | 我們想了解的全部對象 | 個數 N | 全台所有大學生(約 100 萬人) |
| 樣本(Sample) | 從母體中實際取得資料的一部分 | 個數 n | 問卷回收的 500 位大學生 |
| 參數(Parameter) | 描述母體特性的數值,通常未知 | μ(平均)、σ(標準差)、p(比例) | 全台大學生的真正平均睡眠時數 μ |
| 統計量(Statistic) | 由樣本算出來的數值,用來估計參數 | x̄(樣本平均)、s、p̂ | 500 位同學的平均睡眠 x̄ = 6.5 小時 |
記憶口訣:「母體配參數,樣本配統計量」(Population–Parameter,Sample–Statistic,開頭字母剛好相同)。
為什麼不直接調查母體?
調查全部對象稱為普查(Census),例如行政院主計總處每十年辦理的「人口及住宅普查」。但普查通常:
- 太貴、太慢:要訪問 100 萬名大學生,成本驚人。
- 有時不可能:例如檢驗一批燈泡的壽命,全部測完就沒有燈泡可以賣了(破壞性檢驗)。
所以實務上我們常用抽樣:只要樣本抽得好,用少數人也能相當準確地推估整體。
⚠️ 注意:參數是固定的(雖然我們不知道),統計量則會隨著抽到的樣本不同而改變。這個觀念在單元 4「抽樣分配」會再深入說明,本單元的 Python 實作也會讓你親眼看到。
四、資料類型:四種測量尺度
拿到資料後,第一件事是判斷每個變數是什麼類型,因為類型決定了你可以用哪些統計方法和圖表。
先認識兩個基本詞彙
- 觀察值(Observation):一筆資料,通常是表格中的一列,例如一位受訪同學。
- 變數(Variable):觀察值的某一項特徵,通常是表格中的一欄,例如「性別」、「身高」。
四種測量尺度(由低到高)
| 尺度 | 特性 | 可做的運算 | 台灣生活例子 |
|---|---|---|---|
| 名目尺度(Nominal) | 只是分類、貼標籤,沒有順序 | 計次、眾數 | 性別、科系、通勤方式、血型、捷運路線(板南線、淡水信義線) |
| 順序尺度(Ordinal) | 有分類,而且有先後順序,但間距不一定相等 | +排序、中位數 | 年級(大一~大四)、飲料甜度(無糖、微糖、半糖、少糖、全糖)、滿意度(1~5 分)、颱風強度(輕度、中度、強烈) |
| 區間尺度(Interval) | 有順序,間距相等,但沒有絕對零點 | +加減、平均數 | 攝氏溫度、民國年 |
| 比率尺度(Ratio) | 間距相等,而且有絕對零點(0 代表「沒有」) | +乘除、倍數比較 | 身高、體重、月收入、零用錢、睡眠時數、每週喝幾杯手搖飲 |
區間 vs. 比率:「零」是關鍵
- 氣溫 0°C 不代表「沒有溫度」,而且 30°C 也不是 15°C 的「兩倍熱」→ 區間尺度。
- 零用錢 0 元就是「完全沒有零用錢」,10,000 元確實是 5,000 元的兩倍 → 比率尺度。
常見陷阱
- 用數字編碼的類別仍然是類別。 學號、身分證字號、郵遞區號、電話號碼雖然是數字,但拿來相加或平均毫無意義,屬於名目尺度。
- 李克特量表(如滿意度 1~5 分)嚴格來說是順序尺度。「5 分」不一定剛好比「4 分」多一個單位的滿意度。不過實務研究中,常會把多題加總的量表分數近似當成區間尺度處理,使用時要說明清楚。
- 名目和順序合稱類別變數(Categorical / Qualitative);區間和比率合稱數值變數(Numerical / Quantitative)。
五、離散 vs. 連續
數值變數還可以再分成:
| 類型 | 定義 | 判斷方式 | 例子 |
|---|---|---|---|
| 離散(Discrete) | 只能取可數的特定值,通常是整數 | 「數得出來」:幾個、幾次、幾人 | 每週運動次數、家中人數、一天收到的 LINE 訊息數、一節課遲到人數 |
| 連續(Continuous) | 在一個範圍內可以取任何值,只受量測精度限制 | 「量出來的」:多長、多重、多久 | 身高、體重、通勤時間、睡眠時數、氣溫 |
💡 判斷小訣竅:問自己「這是數出來的,還是量出來的?」數出來的多半是離散,量出來的多半是連續。
金額(例如零用錢以「元」為單位)嚴格來說是離散,但因為可能值非常多,實務上常當作連續變數來分析。
六、抽樣方法
樣本抽得好不好,決定了推論是否可信。抽樣方法分成兩大類:
(一)機率抽樣:每個人被抽中的機率是已知的
| 方法 | 做法 | 校園例子 | 優點/缺點 |
|---|---|---|---|
| 簡單隨機抽樣(Simple Random Sampling) | 母體中每個人被抽中的機率相同,像抽籤或用亂數 | 從全校學生名冊用電腦亂數抽出 300 人 | 最公平、理論最單純;需要完整名冊 |
| 系統抽樣(Systematic Sampling) | 先隨機決定起點,再每隔 k 個抽一個 | 學號排序後,從第 3 號開始,每隔 10 號抽一人 | 操作簡單;若名冊有週期性會產生偏誤 |
| 分層抽樣(Stratified Sampling) | 先依某特徵把母體分成幾「層」,再從每一層分別隨機抽樣 | 依大一到大四分層,每個年級各抽 75 人 | 確保各群體都有代表;需事先知道分層資訊 |
| 集群抽樣(Cluster Sampling) | 把母體分成許多「群」,隨機抽出幾個群,被抽中的群全部調查 | 隨機抽出 5 個班級,這 5 班全班同學都填問卷 | 省時省錢;若群和群差異大,誤差較大 |
💡 分層 vs. 集群怎麼分? 分層是「每一層都抽一些人」;集群是「抽幾個群,群內全部調查」。
(二)非機率抽樣:方便,但容易有偏誤
| 方法 | 例子 | 可能的問題 |
|---|---|---|
| 便利抽樣(Convenience Sampling) | 在學餐門口訪問路過的同學 | 只問到會去學餐的人,不吃學餐的人被忽略 |
| 自願回應樣本(Voluntary Response) | 網路投票、粉專「留言 +1」 | 意見強烈的人才會回應,結果容易偏向極端 |
| 滾雪球抽樣(Snowball Sampling) | 請受訪者再介紹朋友填問卷 | 樣本集中在同一個交友圈 |
抽樣偏誤(Sampling Bias)
當樣本有系統地不同於母體時,就產生偏誤。例如:只在平日上午打市內電話做民調,會漏掉上班族和只用手機的年輕人,這就是為什麼現在台灣的民調多採「市話+手機」雙底冊設計。
⚠️ 記住:樣本大不代表好。一萬份網路投票,可能還不如一千份隨機抽樣的電話訪問可靠。
七、Python 實作:讀入資料並判斷變數類型
範例資料說明
本單元使用 students.csv,內容是 30 位學生的「虛構」問卷資料(由程式隨機產生,非真實個資,人物與數值皆為虛構),共 12 個變數:
📥 下載範例資料:students.csv | 📥 完整程式碼:unit01.py
| 欄位名稱 | 中文說明 | 範例值 |
|---|---|---|
student_id |
學生編號(虛構) | S001 |
gender |
性別 | 男、女 |
grade |
年級 | 大一~大四 |
department |
科系 | 資管系、企管系、財金系、觀光系 |
commute |
主要通勤方式 | 機車、捷運、公車、步行、自行車 |
sleep_hours |
平均每日睡眠時數(小時) | 6.6 |
exercise_per_week |
每週運動次數 | 0~5 |
height_cm |
身高(公分) | 164.8 |
monthly_allowance |
每月零用錢(元) | 13500 |
satisfaction |
對校園生活滿意度(1=非常不滿意,5=非常滿意) | 1~5 |
body_temp_c |
填答當天體溫(°C) | 36.6 |
drinks_per_week |
每週喝手搖飲杯數 | 0~7 |
環境準備
建議使用 Google Colab(免安裝,瀏覽器即可)或 Anaconda 的 Jupyter Notebook。若在自己電腦執行,請先安裝套件:
pip install pandas matplotlib
把 students.csv 和程式放在同一個資料夾(使用 Colab 的同學,請先點左側📁圖示上傳 students.csv)。下面每一個程式區塊可以當成 Notebook 的一個儲存格(cell),依序執行。
儲存格 1:匯入套件、設定中文字型
import pandas as pd
import matplotlib.pyplot as plt

# 讓圖表可以顯示繁體中文(依序嘗試 Windows / macOS / Linux 的字型)
plt.rcParams["font.sans-serif"] = [
    "Microsoft JhengHei", "PingFang TC", "Noto Sans CJK TC",
    "Noto Serif CJK TC", "Arial Unicode MS", "DejaVu Sans",
]
plt.rcParams["axes.unicode_minus"] = False  # 讓負號正常顯示
說明:pandas 負責處理表格資料,習慣簡寫成 pd;matplotlib.pyplot 負責畫圖,簡寫成 plt。matplotlib 預設字型沒有中文,所以要指定中文字型,否則圖上的中文會變成方塊。
🔧 Colab 使用者:Colab 預設沒有繁體中文字型,可先執行
!apt-get -qq install fonts-noto-cjk,再到選單「執行階段 → 重新啟動工作階段」後重跑本儲存格。
儲存格 2:讀入 CSV 資料
df = pd.read_csv("students.csv", encoding="utf-8-sig")
print(df.shape)   # (列數, 欄數)
df.head()         # 顯示前 5 筆
執行結果(節錄):
(30, 12)
  student_id gender grade department commute  sleep_hours  ...
0       S001      男    大一      資管系      步行          6.6  ...
1       S002      女    大二      觀光系      機車          4.9  ...
2       S003      女    大三      觀光系      機車          6.7  ...
說明:
pd.read_csv()把 CSV 讀成一個 DataFrame(資料框),你可以把它想成 Python 裡的 Excel 工作表。我們習慣把它命名為df。encoding="utf-8-sig"可以正確讀取含中文、且用 Excel 存過的 CSV 檔。df.shape告訴我們有 30 列(30 位觀察值)、12 欄(12 個變數)。
儲存格 3:pandas 自動判斷的資料型別
df.dtypes
執行結果:
student_id               object
gender                   object
grade                    object
department               object
commute                  object
sleep_hours             float64
exercise_per_week         int64
height_cm               float64
monthly_allowance         int64
satisfaction              int64
body_temp_c             float64
drinks_per_week           int64
說明:
object(pandas 3.0 以後顯示為str):文字。int64:整數;float64:有小數點的數字。
⚠️ 重要觀念:pandas 的「型別」不等於統計上的「測量尺度」! 例如 satisfaction(滿意度 1~5)被 pandas 判斷成整數 int64,但它其實是順序尺度——你不能說「滿意度 4 分是 2 分的兩倍滿意」。電腦只看得出「長得像數字」,判斷尺度要靠人。
儲存格 4:人工標註測量尺度,製作變數類型對照表
measurement_level = {
    "student_id":        ("名目(識別碼)", "—"),
    "gender":            ("名目", "—"),
    "grade":             ("順序", "—"),
    "department":        ("名目", "—"),
    "commute":           ("名目", "—"),
    "sleep_hours":       ("比率", "連續"),
    "exercise_per_week": ("比率", "離散"),
    "height_cm":         ("比率", "連續"),
    "monthly_allowance": ("比率", "離散(以元計,常視為連續)"),
    "satisfaction":      ("順序", "—"),
    "body_temp_c":       ("區間", "連續"),
    "drinks_per_week":   ("比率", "離散"),
}

summary = pd.DataFrame({
    "pandas型別": df.dtypes.astype(str),
    "不同值個數": df.nunique(),
    "測量尺度": {k: v[0] for k, v in measurement_level.items()},
    "離散/連續": {k: v[1] for k, v in measurement_level.items()},
})
summary
執行結果:
                  pandas型別  不同值個數     測量尺度          離散/連續
student_id          object     30  名目(識別碼)              —
gender              object      2       名目              —
grade               object      4       順序              —
department          object      4       名目              —
commute             object      5       名目              —
sleep_hours        float64     21       比率             連續
exercise_per_week    int64      6       比率             離散
height_cm          float64     29       比率             連續
monthly_allowance    int64     17       比率  離散(以元計,常視為連續)
satisfaction         int64      5       順序              —
body_temp_c        float64     10       區間             連續
drinks_per_week      int64      7       比率             離散
說明:
df.nunique()計算每一欄有幾種不同的值,是判斷類型的好幫手:不同值很少(如gender只有 2 種)通常是類別變數;不同值很多(如height_cm有 29 種)多半是連續變數。body_temp_c(攝氏體溫)是區間尺度:0°C 不代表沒有溫度。student_id每個人都不一樣(30 種),它只是用來識別身分的標籤,不需要分析。
儲存格 5:把類別變數轉成正確的型別
# 名目變數:沒有順序的類別
for col in ["gender", "department", "commute"]:
    df[col] = df[col].astype("category")

# 順序變數:要告訴 pandas 正確的先後順序
df["grade"] = pd.Categorical(df["grade"],
                             categories=["大一", "大二", "大三", "大四"],
                             ordered=True)
df["satisfaction"] = pd.Categorical(df["satisfaction"],
                                    categories=[1, 2, 3, 4, 5],
                                    ordered=True)

# 順序變數可以比較先後:篩選出「大三以上」的同學
upper = df[df["grade"] >= "大三"]
print("大三以上的人數:", len(upper), ";年級最高為:", df["grade"].max())
df.dtypes
執行結果(節錄):
大三以上的人數: 14 ;年級最高為: 大四
gender          category
grade           category
department      category
commute         category
satisfaction    category
...
說明:category 型別讓 pandas 知道這是類別資料。加上 ordered=True 之後,grade 就變成有順序的類別,可以用 >= 比較「大三以上」——這正是順序尺度的特性。如果沒有指定順序,文字會依照字元編碼排序,結果可能不是你要的「大一、大二、大三、大四」。
儲存格 6:不同類型,用不同的摘要方式
# 名目變數:計算次數
print(df["commute"].value_counts())

# 順序變數:依照順序列出次數
print(df["satisfaction"].value_counts(sort=False))

# 數值變數:平均數、標準差、最小值、四分位數、最大值
df[["sleep_hours", "height_cm", "monthly_allowance"]].describe().round(2)
執行結果(節錄):
commute
機車     11
捷運      8
公車      7
步行      3
自行車     1

satisfaction
1     2
2     3
3     9
4    13
5     3

       sleep_hours  height_cm  monthly_allowance
count        30.00      30.00              30.00
mean          6.69     164.21           10383.33
std           0.89       8.99            3473.26
min           4.50     147.80            4000.00
max           8.10     180.90           14500.00
說明:
- 類別變數適合用
value_counts()計次;算「通勤方式的平均」是沒有意義的。 - 數值變數適合用
describe()看平均數、標準差等摘要——這些就是下一單元「敘述統計」的主角。
儲存格 7:畫圖——類別用長條圖、連續用直方圖
fig, axes = plt.subplots(1, 2, figsize=(10, 4))

df["commute"].value_counts().plot(kind="bar", ax=axes[0], color="#4C72B0")
axes[0].set_title("通勤方式(名目變數)→ 長條圖")
axes[0].set_xlabel("通勤方式")
axes[0].set_ylabel("人數")
axes[0].tick_params(axis="x", rotation=0)

df["sleep_hours"].plot(kind="hist", bins=6, ax=axes[1],
                       color="#55A868", edgecolor="white")
axes[1].set_title("每日睡眠時數(連續變數)→ 直方圖")
axes[1].set_xlabel("小時")
axes[1].set_ylabel("人數")

plt.tight_layout()
plt.savefig("unit01_charts.png", dpi=120)
plt.show()
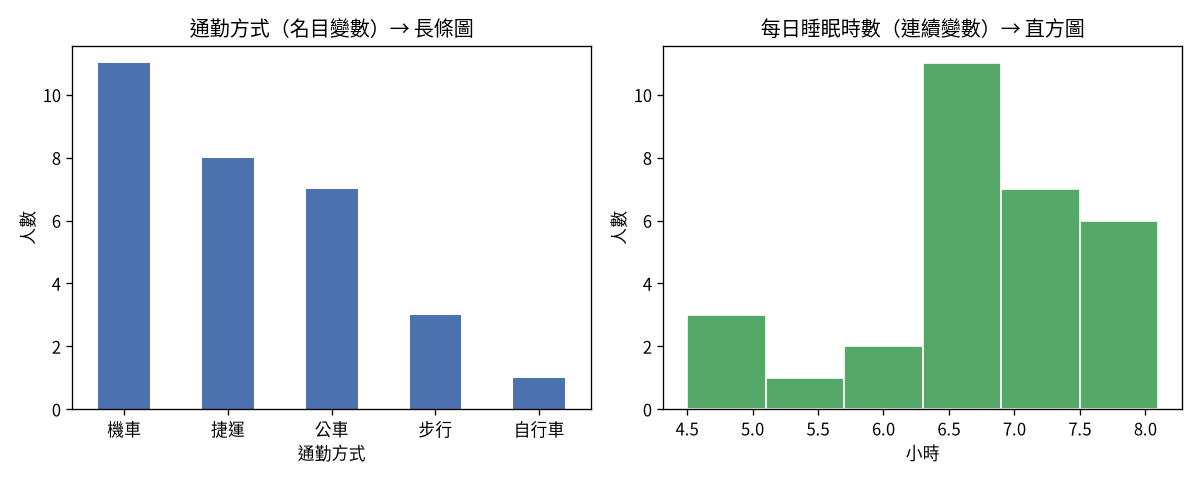
說明:
- 長條圖(Bar chart):用於類別變數,長條之間有間隔,順序可以調換。
- 直方圖(Histogram):用於連續變數,長條緊密相連,代表連續的數值區間;
bins=6表示分成 6 個區間。 - 從直方圖可以看到,多數同學每天睡 6.5~7 小時左右,也有少數同學只睡 4.5~5 小時。
儲存格 8:模擬抽樣——親眼看到「參數」與「統計量」的差別
假設這 30 位同學就是我們關心的整個母體,那麼 30 人的平均睡眠時數就是參數 μ。接著用四種機率抽樣方法各抽一次樣本,計算統計量 x̄:
# 母體參數
mu = df["sleep_hours"].mean()
print(f"母體平均睡眠時數 μ(參數)= {mu:.2f} 小時")

# (a) 簡單隨機抽樣:抽 10 人
srs = df.sample(n=10, random_state=42)
print(f"簡單隨機抽樣:x̄ = {srs['sleep_hours'].mean():.2f}")

# (b) 系統抽樣:每隔 k=3 人抽 1 人
systematic = df.iloc[0::3]
print(f"系統抽樣:x̄ = {systematic['sleep_hours'].mean():.2f}")

# (c) 分層抽樣:每個年級各抽 2 人
stratified = df.groupby("grade", observed=True).sample(n=2, random_state=42)
print(f"分層抽樣:x̄ = {stratified['sleep_hours'].mean():.2f}")

# (d) 集群抽樣:隨機抽出 1 個系,該系全部同學都納入
chosen = df["department"].drop_duplicates().sample(n=1, random_state=7).iloc[0]
cluster = df[df["department"] == chosen]
print(f"集群抽樣(抽中{chosen}):x̄ = {cluster['sleep_hours'].mean():.2f}")

# (e) 重複簡單隨機抽樣 5 次
means = [df.sample(n=10, random_state=s)["sleep_hours"].mean() for s in range(5)]
print("重複抽樣 5 次的 x̄:", [round(float(m), 2) for m in means])
執行結果:
母體平均睡眠時數 μ(參數)= 6.69 小時
簡單隨機抽樣:x̄ = 7.04
系統抽樣:x̄ = 6.91
分層抽樣:x̄ = 7.01
集群抽樣(抽中財金系):x̄ = 6.86
重複抽樣 5 次的 x̄: [6.73, 6.65, 6.59, 6.34, 6.57]
說明:
df.sample(n=10, random_state=42):隨機抽 10 列。random_state是亂數種子,設定後每次執行結果都相同,方便大家對照答案;拿掉它,每次就會抽到不同的人。df.iloc[0::3]:從第 0 列開始,每隔 3 列取一列,就是系統抽樣。groupby("grade").sample(n=2):先按年級分層,再從每層抽 2 人,就是分層抽樣。- 觀察重點:參數 μ=6.69 永遠不變,但每次抽樣得到的 x̄ 都不一樣,有時高、有時低,圍繞在 μ 附近。「統計量會隨樣本變動」這件事,就是單元 4〈抽樣分配與中央極限定理〉的起點。
八、本單元重點整理
- 統計=蒐集、整理、分析、解釋資料,在不確定中做出合理判斷。
- 敘述統計描述手上的資料;推論統計用樣本推論母體,並說明不確定性。
- 母體配參數(μ, σ, p),樣本配統計量(x̄, s, p̂);參數固定,統計量隨樣本變動。
- 四種尺度:名目(分類)→ 順序(可排序)→ 區間(等距、無絕對零點)→ 比率(有絕對零點,可算倍數)。
- 離散是數出來的,連續是量出來的。
- 機率抽樣(簡單隨機、系統、分層、集群)才能做可靠的推論;便利抽樣與自願回應容易產生偏誤。
- 在 Python 中,pandas 的 dtype 不等於測量尺度,判斷資料類型要靠人,再用
category、ordered=True告訴電腦。
九、課後練習
第 1 題|判斷測量尺度
請判斷下列變數屬於名目、順序、區間或比率尺度:
(a) 搭乘的捷運路線(文湖線、板南線……)
(b) 颱風強度(輕度、中度、強烈)
(c) 台北市每日最高氣溫(°C)
(d) 每月花在手搖飲的金額(元)
(e) 身分證字號
第 2 題|母體、樣本、參數、統計量
某民調中心以隨機撥號方式,成功訪問 1,068 位全台 20 歲以上民眾,其中 42% 表示「贊成延長捷運營運時間」,並據此推估全國的贊成比例。請指出這個例子中的母體、樣本、參數與統計量,並說明這屬於敘述統計還是推論統計。
第 3 題|離散或連續
請判斷下列變數是離散還是連續:
(a) 一天收到的 LINE 訊息則數
(b) 從家裡到學校的通勤時間
(c) 家中同住人數
(d) 早餐店一杯大冰奶的實際容量(毫升)
第 4 題|辨識抽樣方法
學生會想了解全校學生對學餐的滿意度,提出了下列五種做法,請判斷各屬於哪一種抽樣方法,並指出哪些可能有明顯偏誤:
(a) 從全校學生名冊用電腦亂數抽出 300 人
(b) 先依學院分組,每個學院按人數比例隨機抽出學生
(c) 隨機抽出 8 個班級,這 8 班的同學全部填問卷
(d) 中午站在學餐門口,訪問經過的同學
(e) 在學生會 Instagram 發限動投票,讓大家自由填答
第 5 題|Python 實作
使用 students.csv,撰寫程式完成以下任務:
(a) 計算 exercise_per_week(每週運動次數)的平均數。
(b) 計算「每週運動 0 次」的同學人數與比例。
(c) 說明 exercise_per_week 是離散還是連續變數,以及屬於哪一種測量尺度。
十、練習題參考答案
📝 建議先自己作答,再對照答案喔!
第 1 題
(a) 名目尺度:路線只是分類,沒有高低順序。
(b) 順序尺度:有強弱順序,但「強烈」和「中度」的差距不一定等於「中度」和「輕度」的差距。
(c) 區間尺度:溫度差距相等,但 0°C 不代表沒有溫度,也不能說 30°C 是 15°C 的兩倍熱。
(d) 比率尺度:0 元代表完全沒花錢,1,000 元是 500 元的兩倍。
(e) 名目尺度:雖然含有數字,但只是識別用的代碼,相加或平均都沒有意義。
第 2 題 – 母體:全台 20 歲以上的民眾。 – 樣本:成功受訪的 1,068 位民眾。 – 參數:全台 20 歲以上民眾中,真正贊成延長營運時間的比例 p(未知)。 – 統計量:樣本中的贊成比例 p̂=42%。 – 這是推論統計,因為它用樣本結果去「推估全國」的比例。(如果只是說「這 1,068 人中有 42% 贊成」,那就是敘述統計。)
第 3 題
(a) 離散:訊息是一則一則數出來的。
(b) 連續:時間是量出來的,可以是 23.5 分鐘、23.47 分鐘……
(c) 離散:人數只能是整數。
(d) 連續:容量是量出來的,可以是 698.3 毫升等任意值。
第 4 題
(a) 簡單隨機抽樣。
(b) 分層抽樣(按比例分層抽樣)。
(c) 集群抽樣:抽的是「班級」,被抽中的班級全部調查。
(d) 便利抽樣:有明顯偏誤,只訪問到會去學餐的人,不常去學餐(可能正是因為不滿意)的同學被忽略了。
(e) 自願回應樣本:有明顯偏誤,只有有追蹤學生會帳號、而且意見強烈的人才會回應。
第 5 題
import pandas as pd

df = pd.read_csv("students.csv", encoding="utf-8-sig")

# (a) 平均數
print("每週運動次數平均:", round(df["exercise_per_week"].mean(), 2))

# (b) 每週運動 0 次的人數與比例
zero = (df["exercise_per_week"] == 0)
print("運動 0 次的人數:", zero.sum())
print("運動 0 次的比例:", f"{zero.mean():.1%}")

# 補充:完整的次數分配
print(df["exercise_per_week"].value_counts().sort_index())
執行結果:
每週運動次數平均: 1.93
運動 0 次的人數: 9
運動 0 次的比例: 30.0%
(c) exercise_per_week 是離散變數(次數是數出來的整數),屬於比率尺度(0 次代表完全沒有運動,4 次確實是 2 次的兩倍)。
💡 小技巧:
(df["exercise_per_week"] == 0)會產生一欄 True/False,.sum()會把 True 當成 1 加總得到人數,.mean()則直接得到比例。
下一單元預告
學會分辨資料類型之後,下一步就是用數字和圖表把資料「說清楚」。單元 2 我們將學習平均數、中位數、標準差、四分位數與盒鬚圖,並繼續使用本單元的 students.csv 實作。
© SuhsiungAI學習教室(suhsiung.com)・統計應用課程・授課教師:蘇志雄。本單元範例資料 students.csv 為教學用虛構資料,與任何真實人物無關。