統計應用|單元 2:敘述統計——用數字與圖表說清楚資料
SuhsiungAI學習教室 授課教師:蘇志雄
適用對象:大學部・統計初學者 實作工具:Python(pandas、matplotlib)
預估學習時間:講義閱讀 70 分鐘+實作 70 分鐘
← 上一單元:單元 1:統計是什麼——資料類型、母體與樣本
本單元學習目標
完成本單元後,你將能夠:
- 計算並解釋集中趨勢的三個指標:平均數、中位數、眾數,並依資料類型與分布形狀選擇合適的指標。
- 計算並解釋離散程度:全距、變異數、標準差、四分位距(IQR),說明「平均相同、波動不同」的意義。
- 理解百分位數與四分位數,會讀「五數摘要」,並能用百分等級(PR)描述個人在群體中的位置。
- 判斷分布的形狀(對稱、右偏、左偏),並用 1.5×IQR 規則與 z 分數找出可能的離群值。
- 製作類別與數值資料的次數分配表(次數、相對次數、累積次數)。
- 依資料類型與目的選擇正確的圖表:直方圖、盒鬚圖、長條圖。
- 使用 pandas 的
mean()、median()、std()、quantile()、describe()、value_counts()、pd.cut()與groupby()完成描述與分組比較。
一、什麼是敘述統計?
單元 1 提過,敘述統計(Descriptive Statistics)的任務是把手上的資料「整理、摘要、呈現」出來。想像你拿到全班 30 個人的問卷,一列一列看下去,很難說出什麼結論;但如果有人告訴你:
「全班平均每天睡 6.7 小時,一半的人睡不到 6.75 小時,而且有 3 位同學睡不到 5 小時。」
只用一句話,你就掌握了資料的中心、分散與特殊值。這就是敘述統計的威力。
描述一組數值資料,通常要回答四個問題:
| 問題 | 對應的統計概念 | 常用指標/工具 |
|---|---|---|
| 1. 資料大概落在哪裡? | 集中趨勢(Central Tendency) | 平均數、中位數、眾數 |
| 2. 資料有多分散? | 離散程度(Dispersion) | 全距、變異數、標準差、IQR |
| 3. 某個值排在第幾名? | 相對位置(Position) | 百分位數、四分位數、z 分數 |
| 4. 分布長什麼樣子? | 形狀(Shape) | 偏態、離群值、直方圖、盒鬚圖 |
💡 重點觀念:只報告平均數是不夠的!「中心」和「分散」一定要一起看,再搭配圖表檢查形狀與離群值,才能完整描述一組資料。
二、集中趨勢:平均數、中位數、眾數
1. 平均數(Mean)
把所有數值加總,再除以個數:
- 樣本平均數:x̄ = Σxᵢ / n
- 母體平均數:μ = Σxᵢ / N
例:巷口自助餐 5 天的便當花費是 85、90、95、100、130 元,平均數 =(85+90+95+100+130)/5 = 100 元。
平均數用到了每一個數值,資訊最完整;但缺點是容易被極端值拉走。
2. 中位數(Median)
把資料由小到大排序後,位在正中間的值。
- n 為奇數:取第 (n+1)/2 個。例:85、90、95、100、130 → 中位數 95。
- n 為偶數:取中間兩個的平均。例:85、90、95、100、130、200 → 中位數 (95+100)/2 = 97.5。
中位數只看「排在中間的是誰」,不受極端值影響,所以稱為穩健(robust)的指標。
3. 眾數(Mode)
資料中出現次數最多的值。可以沒有眾數,也可以有好幾個(雙峰、多峰)。
- 例:手搖飲店一天的訂單中,甜度「微糖」被點最多次 → 甜度的眾數是「微糖」。
- 例:鞋店最常賣出的尺寸是 26 號 → 進貨時 26 號要多備一些。
眾數是唯一可以用在名目變數的集中趨勢指標。
4. 經典案例:為什麼新聞說「薪資中位數」?
行政院主計總處每年都會公布受僱員工的全年總薪資平均數與中位數,而且平均數總是明顯高於中位數。原因是少數高薪者(例如科技業高階主管、大量分紅的員工)會把平均數往上拉,但大多數人的薪資其實集中在較低的區間。這時候「中位數」比較能代表「一般人」的狀況,所以很多人看到平均薪資會覺得「我又拖累大家了」。
💡 比較口訣:平均數「全員參與、容易被帶風向」;中位數「只看中間、不怕極端值」;眾數「最受歡迎、類別也能用」。
5. 該用哪一個?
| 情況 | 建議指標 | 例子 |
|---|---|---|
| 名目變數 | 眾數 | 最多人使用的通勤方式、最受歡迎的便當主菜 |
| 順序變數 | 中位數(或眾數) | 滿意度 1~5 分、颱風強度 |
| 數值變數、分布大致對稱 | 平均數 | 身高、體溫 |
| 數值變數、明顯偏斜或有極端值 | 中位數 | 薪資、房價、存款、零用錢 |
三、離散程度:全距、變異數、標準差、四分位距
為什麼需要「離散程度」?
假設你每天早上搭兩條公車路線中的一條到學校,兩條路線的平均等車時間都是 10 分鐘:
- 🚌 A 路線:每天等 9~11 分鐘,非常穩定。
- 🚌 B 路線:有時 1 分鐘就來,有時要等 25 分鐘。
平均數一樣,但你一定比較想搭 A 路線,因為B 路線的波動(離散程度)大很多,第一節課很可能會遲到。離散程度就是用來衡量「資料有多分散、多不穩定」。
1. 全距(Range)
全距 = 最大值 − 最小值。計算最簡單,但只用到兩個數值,很容易被極端值影響。
2. 變異數(Variance)與標準差(Standard Deviation)
變異數衡量「每個值離平均數多遠」的平均:先算離差(xᵢ − x̄),平方後加總,再除以個數。
- 樣本變異數:s² = Σ(xᵢ − x̄)² / (n − 1)
- 母體變異數:σ² = Σ(xᵢ − μ)² / N
- 標準差就是變異數開根號:s = √s²,單位和原始資料相同,所以比變異數更好解釋。
例:便當花費 85、90、95、100、130 元,x̄ = 100:
| xᵢ | 離差 xᵢ − x̄ | 離差平方 |
|---|---|---|
| 85 | −15 | 225 |
| 90 | −10 | 100 |
| 95 | −5 | 25 |
| 100 | 0 | 0 |
| 130 | 30 | 900 |
| 合計 | 0 | 1,250 |
s² = 1,250 / (5 − 1) = 312.5(元²),s = √312.5 ≈ 17.68 元。可以解讀為「每天的便當花費,大約和平均差 17.68 元上下」。
⚠️ 為什麼樣本要除以 n − 1? 因為我們用樣本平均數 x̄ 代替未知的 μ,資料離 x̄ 的距離會系統性地偏小,除以 n − 1(而不是 n)可以修正這個低估。這叫做「自由度」的概念,單元 5 會再說明。pandas 的
.var()、.std()預設就是除以 n − 1(ddof=1)。
3. 四分位距(Interquartile Range, IQR)
IQR = Q3 − Q1,代表中間 50% 資料的範圍。它和中位數一樣不受極端值影響,所以資料偏斜時,常用「中位數+IQR」搭配報告;資料對稱時,用「平均數+標準差」。
4. 變異係數(Coefficient of Variation, CV)
想比較「身高(公分)」和「零用錢(元)」哪個比較分散?單位不同不能直接比標準差,這時可用變異係數 CV = s / x̄,把分散程度換成「相對於平均數的百分比」。
| 指標 | 用到的資訊 | 受極端值影響 | 適合搭配 |
|---|---|---|---|
| 全距 | 最大、最小值 | 非常大 | 快速粗估 |
| 變異數/標準差 | 所有數值 | 大 | 平均數(對稱分布) |
| IQR | Q1、Q3 | 小 | 中位數(偏斜分布) |
| 變異係數 | 標準差、平均數 | 大 | 比較不同單位的變數 |
四、百分位數與四分位數
1. 百分位數(Percentile)
第 p 百分位數(Pₚ):有 p% 的資料小於或等於這個值。
台灣同學最熟悉的例子就是會考、學測的百分等級(PR 值):PR 85 代表你的成績贏過大約 85% 的考生。另一個例子是兒童健康手冊裡的生長曲線:如果寶寶的體重落在第 50 百分位,代表在同年齡、同性別的寶寶中位居中間;落在第 3 百分位以下或第 97 百分位以上,醫師就會特別留意。
⚠️ 注意:「PR 85」不是「考 85 分」,也不是「答對 85%」,而是相對位置。
2. 四分位數(Quartiles)
把排序後的資料切成四等分的三個切點:
| 四分位數 | 等同於 | 意義 |
|---|---|---|
| Q1(第一四分位數) | P25 | 有 25% 的資料 ≤ Q1 |
| Q2(第二四分位數) | P50 = 中位數 | 有 50% 的資料 ≤ Q2 |
| Q3(第三四分位數) | P75 | 有 75% 的資料 ≤ Q3 |
3. 五數摘要(Five-number Summary)
最小值、Q1、中位數、Q3、最大值,這五個數字就能勾勒出資料的輪廓,也是盒鬚圖的骨架。
💡 小提醒:四分位數的算法不只一種。 課本手算、Excel 的
QUARTILE.INC與QUARTILE.EXC、pandas 的quantile()可能得到略有差異的答案(尤其資料很少時)。pandas 預設使用「線性內插」(interpolation="linear"),結果與 Excel 的QUARTILE.INC相同。考試時請依老師指定的方法計算;報告時說明使用的方法即可。
五、分布的形狀:偏態與離群值
1. 對稱與偏態(Skewness)
| 形狀 | 長相 | 平均數 vs. 中位數 | 台灣生活例子 |
|---|---|---|---|
| 對稱 | 左右大致相同,像一座鐘 | 平均數 ≈ 中位數 | 成年男性身高、體溫 |
| 右偏(正偏) | 右邊拖著一條長尾巴 | 平均數 > 中位數 | 薪資、房價、存款、網購每月消費 |
| 左偏(負偏) | 左邊拖著一條長尾巴 | 平均數 < 中位數 | 很簡單的小考成績(多數人高分,少數人失常)、睡眠時數(多數人睡得差不多,少數人熬夜到天亮) |
💡 記憶法:偏態的方向看「尾巴拖向哪邊」,平均數會被尾巴「拉過去」。
pandas 的 skew() 會算出偏態係數:
- 約等於 0:大致對稱
- 正值:右偏;負值:左偏
- 經驗法則:|偏態係數| < 0.5 可視為大致對稱;0.5~1 為中度偏斜;> 1 為高度偏斜(樣本很小時,偏態係數本身也不太穩定,請搭配圖形判斷)。
2. 離群值(Outliers)
離群值是和其他資料差異特別大的值。常見的兩種判斷方法:
(一)1.5×IQR 規則(盒鬚圖使用的方法)
- 下圍籬 = Q1 − 1.5 × IQR
- 上圍籬 = Q3 + 1.5 × IQR
- 小於下圍籬或大於上圍籬的值,視為可能的離群值。
(二)z 分數(標準分數)
z = (x − x̄) / s,表示「這個值離平均數幾個標準差」。一般來說,|z| > 2 算是少見,|z| > 3 就非常極端。z 分數也能比較不同單位的成績,例如「國文考 80 分」和「數學考 60 分」哪一科考得相對好。
⚠️ 找到離群值之後,不要急著刪掉! 先問:(1) 是不是輸入錯誤?例如身高 1,650 公分其實是 165.0;(2) 如果資料是真的,它往往很有故事——例如睡眠只有 4.5 小時的同學,可能正在打工或準備考試。處理方式可以是更正、另外說明、或改用中位數與 IQR 這類穩健指標,但必須在報告中交代清楚。
六、次數分配表與圖表選擇
1. 次數分配表(Frequency Table)
| 欄位 | 意義 |
|---|---|
| 次數(Frequency) | 每一類(或每一組)出現幾次 |
| 相對次數(Relative Frequency) | 次數 ÷ 總數,常以百分比表示 |
| 累積次數(Cumulative Frequency) | 由第一類(組)一路加到目前這一類(組)的次數 |
| 累積相對次數 | 累積次數 ÷ 總數 |
- 類別變數:直接計算每一類的次數,例如通勤方式。
- 數值變數:要先分組(分箱,binning),例如零用錢分成「4,000~6,999 元」、「7,000~9,999 元」……。分組時要注意:組距最好相等、各組不重疊也不遺漏、組數通常 5~15 組。
2. 選擇圖表
| 想呈現什麼 | 資料類型 | 建議圖表 | 注意事項 |
|---|---|---|---|
| 各類別的次數或比例 | 類別(名目、順序) | 長條圖(Bar chart) | 長條之間有空隙;名目變數可依次數排序,順序變數要依原本順序排 |
| 一個數值變數的分布形狀 | 數值(連續) | 直方圖(Histogram) | 長條緊密相連;組數(bins)會影響外觀,可多試幾種 |
| 五數摘要、離群值 | 數值 | 盒鬚圖(Boxplot) | 盒子=Q1~Q3,中間線=中位數,圓點=離群值 |
| 比較多個群組的分布 | 數值 × 類別 | 並排盒鬚圖 | 一眼比較各組的中位數、分散與離群值 |
| 占整體的比例 | 類別(類別數少) | 圓餅圖 | 類別多於 5 個時難以閱讀,通常長條圖更好 |
⚠️ 常見錯誤:用直方圖畫「科系人數」(應該用長條圖);用長條圖畫「每一位同學的身高」(看不出分布,應該用直方圖或盒鬚圖);長條圖的縱軸不從 0 開始,讓差異看起來被誇大——政論節目和廣告很常出現這種圖,看到要小心!
七、Python 實作:用 pandas 做敘述統計
範例資料說明
本單元繼續使用單元 1 的 students.csv:30 位學生的「虛構」問卷資料(由程式隨機產生,非真實個資,人物與數值皆為虛構)。本單元主要分析以下變數:
📥 下載範例資料:students.csv | 📥 完整程式碼:unit02.py
| 欄位名稱 | 中文說明 | 資料類型(單元 1) |
|---|---|---|
gender |
性別 | 名目 |
grade |
年級(大一~大四) | 順序 |
department |
科系 | 名目 |
commute |
主要通勤方式 | 名目 |
sleep_hours |
平均每日睡眠時數(小時) | 比率・連續 |
height_cm |
身高(公分) | 比率・連續 |
monthly_allowance |
每月零用錢(元) | 比率・離散(常視為連續) |
drinks_per_week |
每週喝手搖飲杯數 | 比率・離散 |
環境準備
與單元 1 相同,可使用 Google Colab 或 Jupyter Notebook。若在自己電腦執行,請先安裝套件:
pip install pandas matplotlib
把 students.csv 和程式放在同一個資料夾(使用 Colab 的同學,請先點左側📁圖示上傳 students.csv)。下面每一個程式區塊可以當成 Notebook 的一個儲存格(cell),請依序執行。
儲存格 1:匯入套件、設定中文字型與顯示格式
import pandas as pd
import matplotlib.pyplot as plt

# 讓圖表可以顯示繁體中文(依序嘗試 Windows / macOS / Linux 的字型)
plt.rcParams["font.sans-serif"] = [
    "Microsoft JhengHei", "PingFang TC", "Noto Sans CJK TC",
    "Noto Serif CJK TC", "Arial Unicode MS", "DejaVu Sans",
]
plt.rcParams["axes.unicode_minus"] = False  # 讓負號正常顯示

# 讓表格輸出時中文欄位對齊、不要被折行
pd.set_option("display.unicode.east_asian_width", True)
pd.set_option("display.width", 160)
pd.set_option("display.max_columns", None)
說明:前半段和單元 1 相同。display.unicode.east_asian_width 會把中文字當成兩個字元寬,讓輸出的表格對得比較整齊。
🔧 Colab 使用者:Colab 預設沒有繁體中文字型,可先執行
!apt-get -qq install fonts-noto-cjk,再到選單「執行階段 → 重新啟動工作階段」後重跑本儲存格。
儲存格 2:讀入資料,並設定年級的順序
df = pd.read_csv("students.csv", encoding="utf-8-sig")

# 單元 1 學過:順序變數要告訴 pandas 正確的先後
df["grade"] = pd.Categorical(df["grade"],
                             categories=["大一", "大二", "大三", "大四"],
                             ordered=True)

num_cols = ["sleep_hours", "height_cm", "monthly_allowance", "drinks_per_week"]
print(df.shape)
df[["student_id", "gender", "grade", "department"] + num_cols].head()
執行結果:
(30, 12)
  student_id gender grade department  sleep_hours  height_cm  monthly_allowance  drinks_per_week
0       S001     男  大一     資管系          6.6      164.8              13500                3
1       S002     女  大二     觀光系          4.9      161.1               5500                0
2       S003     女  大三     觀光系          6.7      154.8               9500                3
3       S004     男  大四     財金系          7.7      167.9              14000                0
4       S005     女  大一     觀光系          7.4      155.9               5500                5
說明:num_cols 是本單元主要分析的四個數值變數,先存成一個串列,後面就不用一直重打欄位名稱。把 grade 設成有順序的類別很重要,否則後面分組時,pandas 會依「字元編碼」排序,變成「大一、大三、大二、大四」的奇怪順序。
儲存格 3:集中趨勢——平均數、中位數、眾數
s = df["sleep_hours"]
print("睡眠時數 平均數 mean  :", round(s.mean(), 2))
print("睡眠時數 中位數 median:", s.median())
print("睡眠時數 眾數 mode    :", s.mode().tolist())

# 眾數也能用在類別變數
print("通勤方式的眾數:", df["commute"].mode().tolist())
print("每週手搖飲杯數的眾數:", df["drinks_per_week"].mode().tolist())
執行結果:
睡眠時數 平均數 mean  : 6.69
睡眠時數 中位數 median: 6.75
睡眠時數 眾數 mode    : [6.4]
通勤方式的眾數: ['機車']
每週手搖飲杯數的眾數: [1, 3]
說明:
mean()、median()分別計算平均數與中位數。mode()回傳的是一個 Series(因為眾數可能不只一個),所以用.tolist()轉成串列。可以看到drinks_per_week有兩個眾數(雙峰)。- 睡眠時數的平均數比中位數小,暗示資料可能有幾個「特別少」的值把平均往下拉——儲存格 7 會驗證這件事。
儲存格 4:平均數怕極端值,中位數不怕
a = df["monthly_allowance"]
print(f"原始 30 人:平均數 {a.mean():,.0f} 元,中位數 {a.median():,.0f} 元")

# 假設班上轉來一位每月零用錢 15 萬元的同學
a_new = pd.concat([a, pd.Series([150000])], ignore_index=True)
print(f"加入 1 人後:平均數 {a_new.mean():,.0f} 元,中位數 {a_new.median():,.0f} 元")
執行結果:
原始 30 人:平均數 10,383 元,中位數 10,750 元
加入 1 人後:平均數 14,887 元,中位數 11,000 元
說明:只多了一個人,平均數就暴增了好幾千元,中位數卻幾乎不動。這就是為什麼薪資、房價這類資料,新聞常常報導中位數。f"{數值:,.0f}" 會加上千分位逗號並四捨五入到整數。
儲存格 5:離散程度——全距、變異數、標準差、IQR
s = df["sleep_hours"]

data_range = s.max() - s.min()
q1, q3 = s.quantile([0.25, 0.75])
print(f"全距 Range = {s.max()} − {s.min()} = {data_range:.1f} 小時")

# 照公式自己算一次樣本變異數,再和 pandas 對照
manual_var = ((s - s.mean()) ** 2).sum() / (len(s) - 1)
print(f"樣本變異數(自己算)  = {manual_var:.3f}")
print(f"樣本變異數 s.var()    = {s.var():.3f}")
print(f"樣本標準差 s.std()    = {s.std():.3f} 小時")
print(f"母體標準差(ddof=0)  = {s.std(ddof=0):.3f} 小時")
print(f"IQR = Q3 − Q1 = {q3:.3f} − {q1:.3f} = {q3 - q1:.3f} 小時")

# 變異係數:比較不同單位的變數誰比較分散
for col in ["height_cm", "monthly_allowance"]:
    cv = df[col].std() / df[col].mean()
    print(f"{col:<18} 標準差 {df[col].std():>9.2f},變異係數 CV = {cv:.1%}")
執行結果:
全距 Range = 8.1 − 4.5 = 3.6 小時
樣本變異數(自己算)  = 0.785
樣本變異數 s.var()    = 0.785
樣本標準差 s.std()    = 0.886 小時
母體標準差(ddof=0)  = 0.871 小時
IQR = Q3 − Q1 = 7.275 − 6.400 = 0.875 小時
height_cm          標準差      8.99,變異係數 CV = 5.5%
monthly_allowance  標準差   3473.26,變異係數 CV = 33.5%
說明:
- 自己照公式算的變異數,和
s.var()完全相同,證明 pandas 預設除以 n − 1。若要除以 n(母體),加上ddof=0。 - 標準差約 0.89 小時,代表同學的睡眠時數大約在平均數上下 0.9 小時左右浮動。
- 零用錢的標準差數字(三千多)遠大於身高(約 9),但那是因為單位不同;換成變異係數後可以公平比較:零用錢的相對分散程度約為身高的 6 倍。
儲存格 6:百分位數、四分位數與五數摘要
s = df["sleep_hours"]
print("睡眠時數的百分位數:")
print(s.quantile([0.10, 0.25, 0.50, 0.75, 0.90]))

# describe():一次看到 count、平均、標準差與五數摘要
print(df[num_cols].describe().round(2))

# 百分等級:睡 7.5 小時的同學,贏過多少人?
my_sleep = 7.5
pr = (s < my_sleep).mean() * 100
print(f"\n每天睡 {my_sleep} 小時,睡得比 {pr:.0f}% 的同學多(PR 約 {pr:.0f})")
執行結果:
睡眠時數的百分位數:
0.10    5.530
0.25    6.400
0.50    6.750
0.75    7.275
0.90    7.700
Name: sleep_hours, dtype: float64
       sleep_hours  height_cm  monthly_allowance  drinks_per_week
count        30.00      30.00              30.00            30.00
mean          6.69     164.21           10383.33             2.87
std           0.89       8.99            3473.26             2.10
min           4.50     147.80            4000.00             0.00
25%           6.40     156.10            8125.00             1.00
50%           6.75     163.85           10750.00             3.00
75%           7.28     172.35           13500.00             4.00
max           8.10     180.90           14500.00             6.00

每天睡 7.5 小時,睡得比 80% 的同學多(PR 約 80)
說明:
quantile(0.25)就是 Q1,quantile(0.5)就是中位數。describe()中的25%、50%、75%就是 Q1、中位數、Q3,加上min、max就是五數摘要。(s < my_sleep)會得到一欄 True/False,取.mean()就是「比 7.5 小時少的人所占的比例」——這就是百分等級的概念。
儲存格 7:分布形狀——偏態係數與離群值
# (a) 偏態係數:正值右偏、負值左偏
print("偏態係數 skewness:")
print(df[num_cols].skew().round(3))

# (b) 1.5×IQR 規則找離群值
s = df["sleep_hours"]
q1, q3 = s.quantile([0.25, 0.75])
iqr = q3 - q1
lower, upper = q1 - 1.5 * iqr, q3 + 1.5 * iqr
print(f"\n睡眠時數:下圍籬 = {lower:.4f},上圍籬 = {upper:.4f}")
outliers = df[(s < lower) | (s > upper)]
print(outliers[["student_id", "grade", "department", "sleep_hours"]])

# (c) z 分數:離平均數幾個標準差
df["sleep_z"] = (s - s.mean()) / s.std()
print("\n|z| > 2 的同學:")
print(df.loc[df["sleep_z"].abs() > 2, ["student_id", "sleep_hours", "sleep_z"]].round(2))
執行結果:
偏態係數 skewness:
sleep_hours         -0.836
height_cm            0.100
monthly_allowance   -0.491
drinks_per_week      0.092
dtype: float64

睡眠時數:下圍籬 = 5.0875,上圍籬 = 8.5875
   student_id grade department  sleep_hours
1        S002  大二     觀光系          4.9
21       S022  大二     企管系          4.8
22       S023  大三     財金系          4.5

|z| > 2 的同學:
   student_id  sleep_hours  sleep_z
1        S002          4.9    -2.02
21       S022          4.8    -2.13
22       S023          4.5    -2.47
說明:
sleep_hours的偏態係數約 −0.84,屬於中度左偏,呼應了儲存格 3「平均數 < 中位數」的觀察;monthly_allowance也是負值,表示零用錢偏向高的一端、少數人特別少。height_cm接近 0,大致對稱。- 1.5×IQR 規則找出 3 位睡眠不到 5 小時的同學;z 分數法也剛好找到同樣 3 位(z 約 −2.0~−2.5)。這次兩種方法結果一致,但它們的標準不同,結果不一定每次都一樣,這很正常。
- 這些同學的資料不一定是錯的,在實務上應該進一步了解原因,而不是直接刪除。
儲存格 8:次數分配表
# (a) 類別變數:通勤方式
counts = df["commute"].value_counts()
freq = pd.DataFrame({
    "次數": counts,
    "相對次數(%)": (counts / len(df) * 100).round(1),
})
freq["累積次數"] = freq["次數"].cumsum()
freq["累積相對次數(%)"] = freq["相對次數(%)"].cumsum().round(1)
print(freq)

# (b) 數值變數:零用錢先分組,再計次
bins = [4000, 7000, 10000, 13000, 16000]
labels = ["4,000–6,999", "7,000–9,999", "10,000–12,999", "13,000–15,999"]
allowance_group = pd.cut(df["monthly_allowance"], bins=bins,
                         labels=labels, right=False)
table = allowance_group.value_counts(sort=False).to_frame("次數")
table["相對次數(%)"] = (table["次數"] / len(df) * 100).round(1)
table["累積次數"] = table["次數"].cumsum()
print()
print(table)
執行結果:
         次數  相對次數(%)  累積次數  累積相對次數(%)
commute
機車       11         36.7        11             36.7
捷運        8         26.7        19             63.4
公車        7         23.3        26             86.7
步行        3         10.0        29             96.7
自行車      1          3.3        30            100.0

                   次數  相對次數(%)  累積次數
monthly_allowance
4,000–6,999           7         23.3         7
7,000–9,999           4         13.3        11
10,000–12,999         9         30.0        20
13,000–15,999        10         33.3        30
說明:
value_counts()預設由多到少排序;cumsum()是累積加總,用來做累積次數。pd.cut()把數值切成區間。right=False代表區間是「左閉右開」,例如[7000, 10000)包含 7,000 但不包含 10,000,確保每個人只會落在一組。- 分組後的次數分配表就是直方圖的數字版本:可以看到零用錢集中在 1 萬元以上的兩組,占了六成以上。
儲存格 9:選對圖表——直方圖、盒鬚圖、長條圖
fig, axes = plt.subplots(2, 2, figsize=(11, 8))
s = df["sleep_hours"]

# (a) 直方圖:數值變數的分布,並標出平均數與中位數
axes[0, 0].hist(s, bins=8, color="#55A868", edgecolor="white")
axes[0, 0].axvline(s.mean(), color="#C44E52", linestyle="--",
                   label=f"平均數 {s.mean():.2f}")
axes[0, 0].axvline(s.median(), color="#4C72B0", linestyle="-",
                   label=f"中位數 {s.median():.2f}")
axes[0, 0].set_title("睡眠時數 → 直方圖(左偏)")
axes[0, 0].set_xlabel("小時")
axes[0, 0].set_ylabel("人數")
axes[0, 0].legend()

# (b) 盒鬚圖:五數摘要與離群值
axes[0, 1].boxplot(s, orientation="horizontal")  # 舊版 matplotlib(3.10 以前)請改用 vert=False
axes[0, 1].set_title("睡眠時數 → 盒鬚圖(圓點為離群值)")
axes[0, 1].set_xlabel("小時")
axes[0, 1].set_yticks([])

# (c) 長條圖:類別變數的次數
df["commute"].value_counts().plot(kind="bar", ax=axes[1, 0], color="#4C72B0")
axes[1, 0].set_title("通勤方式 → 長條圖")
axes[1, 0].set_xlabel("通勤方式")
axes[1, 0].set_ylabel("人數")
axes[1, 0].tick_params(axis="x", rotation=0)

# (d) 並排盒鬚圖:比較各科系的零用錢
depts = sorted(df["department"].unique())
data = [df.loc[df["department"] == d, "monthly_allowance"] for d in depts]
axes[1, 1].boxplot(data)
axes[1, 1].set_xticks(range(1, len(depts) + 1), depts)
axes[1, 1].set_title("各科系每月零用錢 → 並排盒鬚圖")
axes[1, 1].set_ylabel("元")

plt.tight_layout()
plt.savefig("unit02_charts.png", dpi=120)
plt.show()
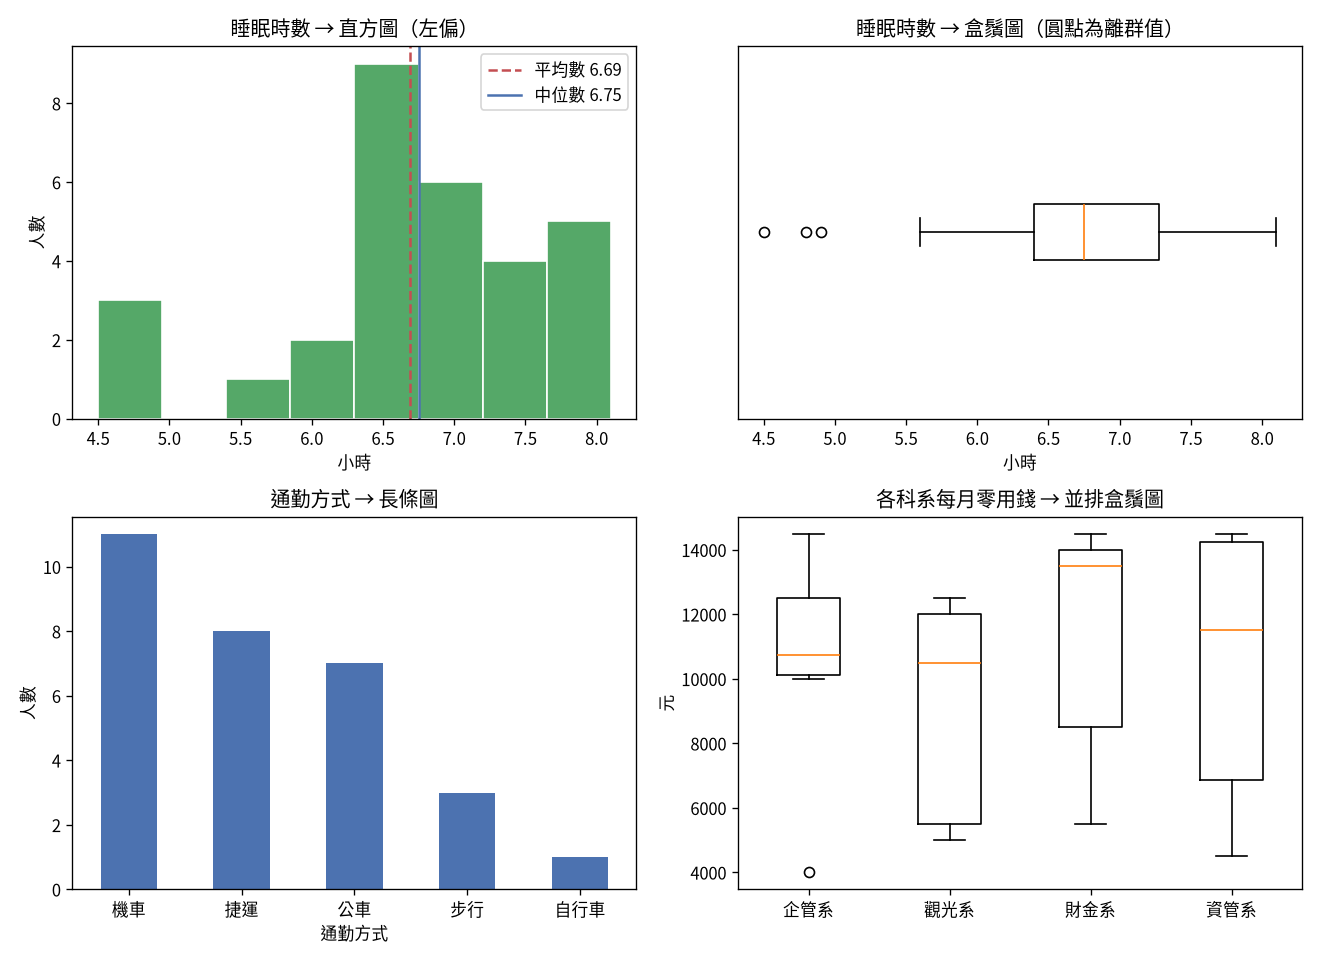
說明:
- 左上直方圖:大部分同學集中在 6~8 小時,左邊拖著一條尾巴;紅色虛線(平均數)在藍色實線(中位數)的左邊,這就是左偏的樣子。
- 右上盒鬚圖:盒子左右兩邊是 Q1 與 Q3,盒中直線是中位數,鬚延伸到圍籬內最遠的資料點;最左邊的圓點就是儲存格 7 找到的 3 個離群值。
- 左下長條圖:通勤方式是名目變數,用長條圖,依人數由多到少排列,一眼看出「機車」最多。
- 右下並排盒鬚圖:同時比較 4 個科系的中位數與分散程度——財金系的中位數最高;資管系的盒子最長(IQR 最大,同學之間差異最大);企管系的盒子最短,但有一位同學只有 4,000 元,在該系被標成離群值。注意:離群值是「相對於自己那一組」判斷的,4,000 元放在全體 30 人中並不算離群。
儲存格 10:分組比較——groupby
# (a) 依性別比較睡眠時數
print(df.groupby("gender")["sleep_hours"]
        .agg(["count", "mean", "median", "std"]).round(2))

# (b) 依科系比較零用錢,依中位數由高到低排序
dept = (df.groupby("department")["monthly_allowance"]
          .agg(["count", "mean", "median", "std", "min", "max"])
          .round(0)
          .sort_values("median", ascending=False))
print()
print(dept)

# (c) 依年級比較多個變數的平均數(grade 是有順序的類別,記得 observed=True)
print()
print(df.groupby("grade", observed=True)[["sleep_hours", "drinks_per_week"]]
        .mean().round(2))

# (d) 交叉表:年級 × 通勤方式
print()
print(pd.crosstab(df["grade"], df["commute"], margins=True, margins_name="合計"))
執行結果:
        count  mean  median   std
gender
女         17  6.45     6.7  0.97
男         13  6.99     6.8  0.68

            count     mean   median     std   min    max
department
財金系          9  11389.0  13500.0  3352.0  5500  14500
資管系          6  10417.0  11500.0  4432.0  4500  14500
企管系          6  10500.0  10750.0  3606.0  4000  14500
觀光系          9   9278.0  10500.0  3093.0  5000  12500

       sleep_hours  drinks_per_week
grade
大一          6.97             3.11
大二          6.30             2.29
大三          6.50             3.29
大四          6.90             2.71

commute  公車  捷運  機車  步行  自行車  合計
grade
大一        3     0     4     2       0     9
大二        2     2     3     0       0     7
大三        1     2     2     1       1     7
大四        1     4     2     0       0     7
合計        7     8    11     3       1    30
說明:
groupby("欄位")的概念是「分組 → 各組計算 → 合併結果」(split–apply–combine),就像 Excel 的樞紐分析表。.agg([...])可以一次算好幾個統計量;sort_values()依某一欄排序。- 女生平均睡 6.45 小時、男生 6.99 小時,女生的標準差(0.97)也比較大——儲存格 7 找到的 3 位睡不到 5 小時的同學,剛好都是女生。
- 財金系零用錢的平均數(約 11,389)明顯低於中位數(13,500),代表該系有少數同學零用錢特別少,把平均往下拉——這時用中位數比較能代表「一般財金系同學」。
pd.crosstab()做出兩個類別變數的交叉次數表,margins=True會加上合計。因為grade已設定順序,列的排列是正確的「大一→大四」。- ⚠️ 本資料每組只有 6~9 人,組間的差異可能只是抽樣的隨機波動。要判斷差異是否「真的存在」,需要單元 6 之後的假設檢定。
八、本單元重點整理
- 集中趨勢:平均數用到全部資料但怕極端值;中位數穩健、適合偏斜資料;眾數適用於類別資料,也可能有多個。
- 離散程度:全距最簡單但最不穩;標準差與原始資料同單位,搭配平均數;IQR 是中間 50% 的範圍,搭配中位數;變異係數可比較不同單位的變數。
- 樣本變異數、標準差除以 n − 1;pandas 的
var()、std()預設就是如此(ddof=1)。 - 百分位數描述相對位置(如 PR 值);五數摘要=最小值、Q1、中位數、Q3、最大值。
- 形狀:右偏時平均數 > 中位數,左偏時平均數 < 中位數;用
skew()與圖形一起判斷。 - 離群值:1.5×IQR 規則或 |z| > 2(或 3);找到後要查明原因,不要直接刪除。
- 圖表選擇:類別→長條圖;數值分布→直方圖;五數摘要與離群值、分組比較→盒鬚圖。
- 在 Python 中,
describe()快速摘要,value_counts()+cumsum()做次數分配表,pd.cut()分組,groupby().agg()做分組比較。
九、課後練習
第 1 題|選擇集中趨勢指標
請判斷下列情況最適合用平均數、中位數或眾數描述,並簡要說明理由:
(a) 某社區 9 戶家庭的月收入,其中 1 戶是上市公司董事長
(b) 早餐店一個早上最多人點的飲料(奶茶、豆漿、紅茶、咖啡)
(c) 全班對「學餐好不好吃」的評分(1=很難吃,5=很好吃)
(d) 大一新生的身高(分布大致對稱)
第 2 題|手算敘述統計量
小安記錄了自己一週 7 天的通勤時間(分鐘):25、30、28、35、30、60、31。
(a) 請計算平均數、中位數、眾數與全距。
(b) 請計算樣本變異數與樣本標準差(四捨五入到小數第二位)。
(c) 星期六那天因為颱風天塞車花了 60 分鐘。你認為用哪一個指標描述小安「平常」的通勤時間比較合適?為什麼?
第 3 題|四分位數與離群值
某大學附近 10 家便當店的招牌便當價格(元)為:85、90、95、100、100、105、110、115、120、180。
請用 pandas 計算 Q1、中位數、Q3 與 IQR,再用 1.5×IQR 規則判斷是否有離群值。
第 4 題|選擇圖表
請為下列情境選擇最合適的圖表(直方圖、盒鬚圖、長條圖),並說明理由:
(a) 呈現全班 50 位同學每月打工收入的分布形狀
(b) 呈現本系各年級的學生人數
(c) 比較台北、台中、高雄三個城市全年每日 PM2.5 濃度的中位數、分散程度與極端值
(d) 呈現受訪者最常使用的社群平台(LINE、Instagram、Facebook、Threads、YouTube)
第 5 題|Python 實作:groupby 分組比較
使用 students.csv,撰寫程式完成以下任務:
(a) 依 grade(年級)分組,計算 drinks_per_week(每週手搖飲杯數)的人數、平均數、中位數與標準差。
(b) 哪一個年級平均每週喝最多杯?
(c) 用 1.5×IQR 規則檢查全體同學的 drinks_per_week 是否有離群值。
十、練習題參考答案
📝 建議先自己作答,再對照答案喔!
第 1 題
(a) 中位數:收入通常右偏,董事長這個極端值會把平均數大幅拉高,中位數較能代表一般家庭。
(b) 眾數:飲料種類是名目變數,只能計次,最多人點的就是眾數。
(c) 中位數(或眾數):評分屬於順序尺度,「5 分」不一定剛好比「4 分」多一個單位,用中位數較妥當;實務上也常同時報告平均數,但要說明是把它近似為區間尺度。
(d) 平均數:分布對稱、沒有明顯極端值時,平均數用到全部資料,資訊最完整(此時平均數 ≈ 中位數)。
第 2 題
(a) 總和 = 25+30+28+35+30+60+31 = 239,平均數 = 239 / 7 ≈ 34.14 分鐘。
排序後為 25、28、30、30、31、35、60,第 4 個是 30,中位數 = 30 分鐘。
30 出現 2 次最多,眾數 = 30 分鐘。
全距 = 60 − 25 = 35 分鐘。
(b) 離差平方和 Σ(xᵢ − x̄)² ≈ 834.86,s² = 834.86 / (7 − 1) ≈ 139.14(分鐘²),s = √139.14 ≈ 11.80 分鐘。
(c) 用中位數(30 分鐘)較合適。60 分鐘是颱風天的特殊狀況,把平均數拉高到 34 分鐘,但小安 7 天中有 6 天都在 25~35 分鐘之間。若去掉 60,平均數會降到約 29.83 分鐘,中位數仍是 30,可見中位數比較穩健。
用 Python 驗算:
import pandas as pd

t = pd.Series([25, 30, 28, 35, 30, 60, 31])
print("平均數:", round(t.mean(), 2))
print("中位數:", t.median())
print("眾數:", t.mode().tolist())
print("全距:", t.max() - t.min())
print("樣本變異數:", round(t.var(), 2))
print("樣本標準差:", round(t.std(), 2))
執行結果:
平均數: 34.14
中位數: 30.0
眾數: [30]
全距: 35
樣本變異數: 139.14
樣本標準差: 11.8
第 3 題
import pandas as pd

price = pd.Series([85, 90, 95, 100, 100, 105, 110, 115, 120, 180])
q1, q2, q3 = price.quantile([0.25, 0.50, 0.75])
iqr = q3 - q1
lower, upper = q1 - 1.5 * iqr, q3 + 1.5 * iqr
print(f"Q1 = {q1},中位數 = {q2},Q3 = {q3},IQR = {iqr}")
print(f"下圍籬 = {lower},上圍籬 = {upper}")
print("離群值:", price[(price < lower) | (price > upper)].tolist())
執行結果:
Q1 = 96.25,中位數 = 102.5,Q3 = 113.75,IQR = 17.5
下圍籬 = 70.0,上圍籬 = 140.0
離群值: [180]
180 元超過上圍籬 140 元,是離群值(可能是附近一家主打高級和牛的便當店)。若用其他四分位數算法(例如課本的手算法),Q1、Q3 可能略有不同,但這題結論相同。
第 4 題
(a) 直方圖:打工收入是連續的數值變數,直方圖最能看出分布形狀(很可能右偏)。
(b) 長條圖:年級是類別(順序)變數,要呈現各類別的人數;請依大一到大四的順序排列。
(c) 並排盒鬚圖:要比較多個群組的中位數、IQR 與極端值,盒鬚圖一眼就能比較(空汙特別嚴重的日子會以離群值圓點出現)。
(d) 長條圖:社群平台是名目變數,依人數由多到少排列最清楚。(類別有 5 個,也可以用圓餅圖,但長條圖較容易比較大小。)
第 5 題
import pandas as pd

df = pd.read_csv("students.csv", encoding="utf-8-sig")
df["grade"] = pd.Categorical(df["grade"],
                             categories=["大一", "大二", "大三", "大四"],
                             ordered=True)

# (a) 依年級分組計算
result = (df.groupby("grade", observed=True)["drinks_per_week"]
            .agg(["count", "mean", "median", "std"]).round(2))
print(result)

# (b) 平均最多的年級
print("平均每週喝最多杯的年級:", result["mean"].idxmax())

# (c) 1.5×IQR 規則
d = df["drinks_per_week"]
q1, q3 = d.quantile([0.25, 0.75])
iqr = q3 - q1
lower, upper = q1 - 1.5 * iqr, q3 + 1.5 * iqr
print(f"Q1 = {q1},Q3 = {q3},IQR = {iqr},圍籬 = [{lower}, {upper}]")
print("離群值個數:", ((d < lower) | (d > upper)).sum())
執行結果:
       count  mean  median   std
grade
大一       9  3.11     3.0  1.83
大二       7  2.29     1.0  2.36
大三       7  3.29     4.0  2.14
大四       7  2.71     2.0  2.43
平均每週喝最多杯的年級: 大三
Q1 = 1.0,Q3 = 4.0,IQR = 3.0,圍籬 = [-3.5, 8.5]
離群值個數: 0
(a)(b) 大三平均每週喝最多杯(約 3.29 杯),中位數也是最高的 4 杯。大二的平均數(2.29)明顯高於中位數(1),代表大二有少數同學喝得特別多、多數同學喝得少,分布偏右。
(c) 下圍籬是 −3.5、上圍籬是 8.5,而全體同學每週喝 0~6 杯,都在圍籬之內,所以沒有離群值。(杯數不可能是負的,下圍籬為負數時,代表低的一端不可能出現離群值。)
💡 小技巧:
idxmax()會回傳最大值所在的「索引」(這裡就是年級名稱),比自己用眼睛找更不容易出錯。
下一單元預告
學會用數字與圖表描述資料之後,我們要開始面對「不確定性」:抽一張發票中獎的機會有多大?為什麼這麼多自然現象的直方圖都長得像一座鐘?單元 3 將介紹機率的基本概念與常態分配,而本單元學到的平均數、標準差與 z 分數,正是理解常態分配的關鍵。
© SuhsiungAI學習教室(suhsiung.com)・統計應用課程・授課教師:蘇志雄。本單元範例資料 students.csv 為教學用虛構資料,與任何真實人物無關。