統計應用|單元 7:變異數分析 ANOVA——一次比較三組以上的平均數
SuhsiungAI學習教室 授課教師:蘇志雄
適用對象:大學部・統計初學者 實作工具:Python(numpy、scipy.stats、pandas、statsmodels、matplotlib)
預估學習時間:講義閱讀 90 分鐘+實作 90 分鐘
← 上一單元:單元 6:假設檢定——用資料回答「是不是真的有差?」
本單元學習目標
完成本單元後,你將能夠:
- 說明比較多組平均數時,為什麼不能兩兩做 t 檢定。
- 理解單因子 ANOVA 的邏輯:把總變異拆成組間變異與組內變異,用 F 值判斷組間差異是否大於隨機誤差。
- 讀懂並手算 ANOVA 表(SS、df、MS、F、p),並用
scipy.stats.f_oneway與 statsmodels 的anova_lm完成分析。 - 檢查 ANOVA 的假設(獨立、常態、變異數相等),使用 Levene 檢定,並在變異數不等時改用 Welch ANOVA。
- 計算並解讀效果量 η²(eta squared)。
- 使用 Tukey HSD 做事後比較,並在不符常態時改用 Kruskal-Wallis 檢定。
- 初步認識雙因子 ANOVA 與交互作用,並用模擬看見整體型一錯誤率(family-wise error rate)。
一、為什麼不能兩兩做 t 檢定?
單元 6 的 t 檢定一次只能比較兩組。想知道「大一到大四的平均睡眠時數是否不同」,4 組兩兩比較就要做 C(4, 2) = 6 次 t 檢定。
每次檢定都有 5% 的機會誤判。如果 6 次彼此獨立,至少一次假陽性的機率約為:
1 − 0.95⁶ ≈ 26.5%
組數越多越嚴重:5 組要比 10 次(約 40%),8 組要比 28 次(約 76%)。這個「整個研究至少犯一次型一錯誤」的機率稱為整體型一錯誤率(family-wise error rate, FWER)。
💡 重點觀念:ANOVA 先用一次 F 檢定回答整體問題「各組平均數是否全部相等?」,把型一錯誤率控制在 α。若顯著,再用事後比較(如 Tukey HSD)找出是哪幾組不同。
二、單因子 ANOVA 的邏輯
1. 假設
- H0:μ1 = μ2 = … = μk(所有組平均數相等)
- H1:至少有一組的平均數不同(不是「全部都不同」)
2. 把變異拆成兩塊
每一個觀察值和總平均的距離,可以拆成「所屬組平均和總平均的距離」加上「它和自己組平均的距離」:
| 變異來源 | 平方和 | 意義 |
|---|---|---|
| 組間(between) | SS組間 = Σ nⱼ(x̄ⱼ − x̄)² | 各組平均數彼此相差多少:訊號 |
| 組內(within) | SS組內 = ΣΣ (xᵢⱼ − x̄ⱼ)² | 同一組內個人之間的差異:雜訊 |
| 總和 | SS總 = ΣΣ (xᵢⱼ − x̄)² | SS總 = SS組間 + SS組內 |
3. F 值:訊號 ÷ 雜訊
F = MS組間 / MS組內,其中 MS = SS / df。
- 若 H0 為真,組間與組內都只是隨機誤差,F 應該接近 1。
- 組間差異越大(相對於組內差異),F 越大,p 值越小。
- F 在 H0 下服從 F 分配,有兩個自由度:df組間 = k − 1、df組內 = N − k。
4. ANOVA 表
| 變異來源 | SS | df | MS | F | p |
|---|---|---|---|---|---|
| 組間 | SS組間 | k − 1 | SS組間/(k − 1) | MS組間/MS組內 | 查 F 分配 |
| 組內 | SS組內 | N − k | SS組內/(N − k) | ||
| 總和 | SS總 | N − 1 |
5. 效果量 η²
η² = SS組間 / SS總:總變異中有多少比例可以由分組解釋。常用參考:0.01 小、0.06 中、0.14 大。η² 在小樣本會高估,較不偏的 ω² 會比較保守。
三、ANOVA 的假設與替代方法
| 假設 | 檢查方式 | 不符合時 |
|---|---|---|
| 獨立:各觀察值彼此獨立 | 由研究設計判斷(隨機抽樣、每人只算一次) | 重複測量要改用重複量數 ANOVA 或混合模型 |
| 常態:各組(殘差)近似常態 | 殘差直方圖、Q-Q 圖、Shapiro-Wilk | 樣本大時 F 檢定相當穩健;小樣本偏態嚴重可用 Kruskal-Wallis |
| 變異數相等 | Levene 檢定(stats.levene)、最大/最小標準差比 |
改用 Welch ANOVA;各組人數不等時尤其重要 |
⚠️ 假設檢定本身也有檢定力的問題:小樣本時 Levene「不顯著」不代表變異數真的相等。最好同時看圖、看標準差比。
Kruskal-Wallis 檢定是 ANOVA 的無母數版本:把所有資料排成等級,比較各組的平均等級。它不需常態假設,適合偏態或有極端值的資料,但檢定的是「分配位置」是否相同,而不是平均數。
四、事後比較:Tukey HSD
ANOVA 顯著只告訴我們「至少一組不同」。要知道哪幾組不同,用 Tukey HSD(Honestly Significant Difference):
- 一次檢定所有兩兩比較,並把整體型一錯誤率控制在 α。
- 每組比較都給一個調整後 p 值與同時信賴區間;區間不含 0 就表示這兩組有顯著差異。
- scipy 使用
stats.tukey_hsd(*groups)。
其他方法:Bonferroni(門檻 α/m,簡單但較保守)、Games-Howell(變異數不等時)。
⚠️ 不要「ANOVA 不顯著,就硬做事後比較找顯著」,這又回到了多重檢定的陷阱。
五、雙因子 ANOVA 與交互作用(簡介)
若同時有兩個分組變數,例如「讀書方法」(3 種)和「睡眠是否充足」(2 種),雙因子 ANOVA 可以一次檢定三件事:
- 方法的主效果:不同讀書方法的平均成績是否不同?
- 睡眠的主效果:睡眠充足與否的平均成績是否不同?
- 交互作用:睡眠的效果是否因讀書方法而異?
在交互作用圖中,若各條線大致平行,代表沒有交互作用;線不平行甚至交叉,代表一個因子的效果取決於另一個因子。交互作用顯著時,解讀主效果要特別小心。statsmodels 公式寫成 成績 ~ C(方法) * C(睡眠),* 會自動包含兩個主效果與交互作用。
六、Python 實作:年級與睡眠時數
範例資料說明
本單元繼續使用單元 1~6 的 students.csv:30 位學生的「虛構」問卷資料(由程式隨機產生,非真實個資,人物與數值皆為虛構)。我們以年級 grade(大一~大四,每組 7~9 人)為分組變數,比較各年級的平均睡眠時數 sleep_hours。雙因子 ANOVA 的「讀書方法 × 睡眠 → 考試成績」則是以程式模擬的教學假設資料,數字不代表任何真實研究。
📥 下載範例資料:students.csv | 📥 完整程式碼:unit07.py
環境準備
本單元新增 statsmodels 套件(Google Colab 已內建)。若在自己電腦執行,請先安裝:
pip install numpy scipy pandas statsmodels matplotlib
把 students.csv 和程式放在同一個資料夾(使用 Colab 的同學,請先點左側📁圖示上傳 students.csv)。下面每一個程式區塊可以當成 Notebook 的一個儲存格(cell),請依序執行——因為所有模擬共用同一個亂數產生器,跳著執行會得到不同的數字。
儲存格 1:匯入套件,依年級分組
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats
import statsmodels.api as sm
import statsmodels.formula.api as smf

# 讓圖表可以顯示繁體中文(依序嘗試 Windows / macOS / Linux 的字型)
plt.rcParams["font.sans-serif"] = [
    "Microsoft JhengHei", "PingFang TC", "Noto Sans CJK TC",
    "Noto Serif CJK TC", "Arial Unicode MS", "DejaVu Sans",
]
plt.rcParams["axes.unicode_minus"] = False  # 讓負號正常顯示

pd.set_option("display.unicode.east_asian_width", True)
pd.set_option("display.width", 160)

# 固定種子,讓每次執行的模擬結果都一樣
rng = np.random.default_rng(2026)

df = pd.read_csv("students.csv", encoding="utf-8-sig")
order = ["大一", "大二", "大三", "大四"]
df["grade"] = pd.Categorical(df["grade"], categories=order, ordered=True)
summary = df.groupby("grade", observed=True)["sleep_hours"].agg(["count", "mean", "std"])
print(summary.round(3).to_string())
groups = [df.loc[df["grade"] == g, "sleep_hours"].to_numpy() for g in order]
執行結果:
       count   mean    std
grade
大一       9  6.967  0.614
大二       7  6.300  1.254
大三       7  6.500  0.988
大四       7  6.900  0.594
說明:大一與大四平均睡將近 7 小時,大二最少(6.30 小時),但大二的標準差也最大(1.25 小時)。這些差異是真的,還是抽樣的偶然?
儲存格 2:兩兩 t 檢定的問題
# 為什麼不能兩兩做 t 檢定?4 組 → C(4,2) = 6 次比較
from itertools import combinations
pairs = list(combinations(range(4), 2))
for i, j in pairs:
    p = stats.ttest_ind(groups[i], groups[j], equal_var=False).pvalue
    print(f"{order[i]} vs {order[j]}:p = {p:.4f}")
print(f"\n6 次獨立檢定、每次 α = 0.05,至少一次假陽性的機率 ≈ 1 − 0.95^6 = {1 - 0.95 ** 6:.3f}")
執行結果:
大一 vs 大二:p = 0.2318
大一 vs 大三:p = 0.3003
大一 vs 大四:p = 0.8298
大二 vs 大三:p = 0.7464
大二 vs 大四:p = 0.2837
大三 vs 大四:p = 0.3807

6 次獨立檢定、每次 α = 0.05,至少一次假陽性的機率 ≈ 1 − 0.95^6 = 0.265
說明:6 次比較都不顯著;但就算全部 H0 為真,6 次不校正的檢定也有約 26% 的機會「至少一次顯著」。這就是需要 ANOVA 的原因。
儲存格 3:手算 ANOVA 表
# 手算 ANOVA:總變異 = 組間變異 + 組內變異
y = df["sleep_hours"].to_numpy()
grand = y.mean()
k, N = len(groups), len(y)
ss_between = sum(len(g) * (g.mean() - grand) ** 2 for g in groups)
ss_within = sum(((g - g.mean()) ** 2).sum() for g in groups)
ss_total = ((y - grand) ** 2).sum()
df_b, df_w = k - 1, N - k
ms_b, ms_w = ss_between / df_b, ss_within / df_w
F = ms_b / ms_w
p_F = stats.f.sf(F, df_b, df_w)
table = pd.DataFrame({
    "平方和 SS": [ss_between, ss_within, ss_total],
    "自由度 df": [df_b, df_w, N - 1],
    "均方 MS": [ms_b, ms_w, np.nan],
    "F": [F, np.nan, np.nan],
    "p 值": [p_F, np.nan, np.nan],
}, index=["組間(年級)", "組內(誤差)", "總和"])
print(table.round(4).to_string())
print(f"\n檢查:SS組間 + SS組內 = {ss_between + ss_within:.4f} = SS總 {ss_total:.4f}")
print(f"F 臨界值(α = 0.05,df = {df_b}, {df_w})= {stats.f.ppf(0.95, df_b, df_w):.3f}")
執行結果:
              平方和 SS  自由度 df  均方 MS       F    p 值
組間(年級)     2.3147          3   0.7716  0.9814  0.4167
組內(誤差)    20.4400         26   0.7862     NaN     NaN
總和            22.7547         29      NaN     NaN     NaN

檢查:SS組間 + SS組內 = 22.7547 = SS總 22.7547
F 臨界值(α = 0.05,df = 3, 26)= 2.975
說明:
- SS組間 = 2.31,SS組內 = 20.44:睡眠時數的差異絕大部分來自同年級內個人之間,而不是年級之間。
- MS組間 0.77 和 MS組內 0.79 幾乎一樣大,F ≈ 0.98,接近 1,遠小於臨界值 2.975。
- p ≈ 0.42 > 0.05,無法拒絕 H0:沒有證據顯示各年級的平均睡眠時數不同。
儲存格 4:scipy 與 statsmodels
# scipy 一行版本
res = stats.f_oneway(*groups)
print(f"stats.f_oneway:F = {res.statistic:.4f},p = {res.pvalue:.4f}")
# statsmodels:用公式建立模型,輸出標準 ANOVA 表
model = smf.ols("sleep_hours ~ C(grade)", data=df).fit()
print(sm.stats.anova_lm(model, typ=2).round(4).to_string())
執行結果:
stats.f_oneway:F = 0.9814,p = 0.4167
           sum_sq    df       F  PR(>F)
C(grade)   2.3147   3.0  0.9814  0.4167
Residual  20.4400  26.0     NaN     NaN
說明:stats.f_oneway 一行算出 F 與 p;statsmodels 的 anova_lm 輸出完整 ANOVA 表(sum_sq 為 SS,PR(>F) 為 p 值),兩者與手算完全相同。statsmodels 的公式寫法之後學迴歸時也會用到。
儲存格 5:效果量 η²
# 效果量 η²(eta squared):組間變異佔總變異的比例
eta2 = ss_between / ss_total
omega2 = (ss_between - df_b * ms_w) / (ss_total + ms_w)
print(f"η² = {eta2:.4f}(約 {eta2:.1%} 的睡眠時數變異可由年級解釋)")
print(f"ω² = {omega2:.4f}(較不偏的版本,小樣本時較保守)")
執行結果:
η² = 0.1017(約 10.2% 的睡眠時數變異可由年級解釋)
ω² = -0.0019(較不偏的版本,小樣本時較保守)
說明:η² ≈ 0.10,看起來是「中等」;但 ω² 接近 0(甚至略小於 0,可視為 0)。小樣本時 η² 會高估效果,這裡年級幾乎沒有解釋力。
儲存格 6:檢查假設
# 檢查假設:(1) 各組殘差近似常態 (2) 變異數相等
resid = model.resid
print(f"殘差 Shapiro-Wilk:W = {stats.shapiro(resid).statistic:.4f},p = {stats.shapiro(resid).pvalue:.4f}")
lev = stats.levene(*groups, center="median")
print(f"Levene 檢定(中位數版,Brown-Forsythe):W = {lev.statistic:.4f},p = {lev.pvalue:.4f}")
print(f"最大 / 最小組標準差 = {summary['std'].max() / summary['std'].min():.2f}(經驗法則:小於 2 較安心)")
執行結果:
殘差 Shapiro-Wilk:W = 0.9848,p = 0.9345
Levene 檢定(中位數版,Brown-Forsythe):W = 1.7017,p = 0.1912
最大 / 最小組標準差 = 2.11(經驗法則:小於 2 較安心)
說明:
- 殘差 Shapiro-Wilk p ≈ 0.93,沒有偏離常態的跡象。
- Levene 檢定 p ≈ 0.19,未達顯著;但最大/最小標準差比約 2.11,略超過經驗法則 2,而且各組人數不等。保險起見,再做一次 Welch ANOVA。
儲存格 7:Welch ANOVA
# 變異數不等時:Welch ANOVA(手算,不需額外套件)
def welch_anova(*gs):
    n_ = np.array([len(g) for g in gs]); m_ = np.array([g.mean() for g in gs]); v_ = np.array([g.var(ddof=1) for g in gs])
    w = n_ / v_
    mw = (w * m_).sum() / w.sum()
    kk = len(gs)
    a = (w * (m_ - mw) ** 2).sum() / (kk - 1)
    lam = ((1 - w / w.sum()) ** 2 / (n_ - 1)).sum()
    b = 1 + 2 * (kk - 2) / (kk ** 2 - 1) * lam
    F_w = a / b
    df2 = (kk ** 2 - 1) / (3 * lam)
    return F_w, kk - 1, df2, stats.f.sf(F_w, kk - 1, df2)

Fw, d1, d2, pw = welch_anova(*groups)
print(f"Welch ANOVA:F = {Fw:.4f},df = ({d1}, {d2:.2f}),p = {pw:.4f}")
執行結果:
Welch ANOVA:F = 0.7793,df = (3, 13.29),p = 0.5258
說明:Welch ANOVA 不假設變異數相等,分母自由度降為約 13.3。p ≈ 0.53,結論相同:無法拒絕 H0。
儲存格 8:Tukey HSD 事後比較
# 事後比較:Tukey HSD(控制整體型一錯誤率)
tk = stats.tukey_hsd(*groups)
rows = []
for i, j in pairs:
    ci = tk.confidence_interval(0.95)
    rows.append({"比較": f"{order[i]} − {order[j]}", "平均差": groups[i].mean() - groups[j].mean(),
                 "95% CI 下限": ci.low[i, j], "95% CI 上限": ci.high[i, j], "調整後 p": tk.pvalue[i, j]})
print(pd.DataFrame(rows).round(4).to_string(index=False))
執行結果:
       比較  平均差  95% CI 下限  95% CI 上限  調整後 p
大一 − 大二  0.6667      -0.5591       1.8925    0.4565
大一 − 大三  0.4667      -0.7591       1.6925    0.7253
大一 − 大四  0.0667      -1.1591       1.2925    0.9988
大二 − 大三 -0.2000      -1.5002       1.1002    0.9742
大二 − 大四 -0.6000      -1.9002       0.7002    0.5919
大三 − 大四 -0.4000      -1.7002       0.9002    0.8330
說明:所有比較的同時信賴區間都包含 0、調整後 p 都很大。實務上 ANOVA 不顯著時通常不必做事後比較,這裡只是示範寫法與輸出格式。
儲存格 9:Kruskal-Wallis 無母數檢定
# 無母數替代:Kruskal-Wallis(比較各組的「等級」,不需常態假設)
kw = stats.kruskal(*groups)
print(f"Kruskal-Wallis:H = {kw.statistic:.4f},p = {kw.pvalue:.4f}")
print("各組中位數:", {g: float(np.median(x)) for g, x in zip(order, groups)})
執行結果:
Kruskal-Wallis:H = 1.7663,p = 0.6223
各組中位數: {'大一': 7.0, '大二': 6.4, '大三': 6.6, '大四': 6.8}
說明:H ≈ 1.77,p ≈ 0.62,與 ANOVA 的結論一致。資料偏態或有極端值時,可以把 Kruskal-Wallis 當成穩健性檢查。
儲存格 10:雙因子 ANOVA 與交互作用(教學假設資料)
# 雙因子 ANOVA(教學假設資料):讀書方法 × 睡眠充足與否 對考試成績的影響
methods = ["自己讀", "讀書會", "線上課程"]
rows = []
for mi, mth in enumerate(methods):
    for slp in ["睡眠不足", "睡眠充足"]:
        base = 70 + [0, 4, 2][mi] + (5 if slp == "睡眠充足" else 0)
        if mth == "讀書會" and slp == "睡眠充足":
            base += 7                                  # 交互作用:讀書會在睡飽時效果特別好
        for s_ in rng.normal(base, 6, size=10):
            rows.append({"方法": mth, "睡眠": slp, "成績": round(s_, 1)})
exam = pd.DataFrame(rows)
print(exam.pivot_table(index="方法", columns="睡眠", values="成績", aggfunc="mean").loc[methods, ["睡眠不足", "睡眠充足"]].round(2).to_string())
m2 = smf.ols("成績 ~ C(方法) * C(睡眠)", data=exam).fit()
print()
print(sm.stats.anova_lm(m2, typ=2).round(4).to_string())
執行結果:
睡眠      睡眠不足  睡眠充足
方法
自己讀       69.25     74.57
讀書會       75.09     87.42
線上課程     77.15     78.83

                    sum_sq    df        F  PR(>F)
C(方法)           899.7043   2.0  13.3367  0.0000
C(睡眠)           622.7482   1.0  18.4626  0.0001
C(方法):C(睡眠)   293.0203   2.0   4.3436  0.0178
Residual         1821.4370  54.0      NaN     NaN
說明:
- 方法與睡眠的主效果都顯著(p < 0.001)。
- 交互作用也顯著(p ≈ 0.018):睡飽對「讀書會」的幫助(約 +12 分)遠大於「線上課程」(約 +2 分)。這時不能只說「睡飽平均多幾分」,要分方法來描述。
儲存格 11:模擬整體型一錯誤率
# 模擬:H0 為真(4 組平均都相同)時,兩兩 t 檢定 vs. 一次 ANOVA vs. Tukey 的整體型一錯誤率
reps, n_g = 10_000, 8
sims = rng.normal(6.7, 0.9, size=(reps, 4, n_g))             # 10,000 次實驗 × 4 組 × 每組 8 人
p_pairs = np.stack([stats.ttest_ind(sims[:, i], sims[:, j], axis=1).pvalue for i, j in pairs], axis=1)
p_anova = stats.f_oneway(*[sims[:, g] for g in range(4)], axis=1).pvalue
# Tukey HSD:最大平均差 ÷ √(MS組內 / n) 與學生化全距分配的臨界值比較
m_g = sims.mean(axis=2)
msw = sims.var(axis=2, ddof=1).mean(axis=1)
q = (m_g.max(axis=1) - m_g.min(axis=1)) / np.sqrt(msw / n_g)
q_crit = stats.studentized_range.ppf(0.95, 4, 4 * (n_g - 1))
print(f"兩兩 t 檢定(6 次,不校正)至少一次顯著:{(p_pairs < 0.05).any(axis=1).mean():.4f}")
print(f"Bonferroni(門檻 0.05/6)至少一次顯著:{(p_pairs < 0.05 / 6).any(axis=1).mean():.4f}")
print(f"一次 ANOVA F 檢定顯著:{(p_anova < 0.05).mean():.4f}")
print(f"Tukey HSD 至少一組顯著:{(q > q_crit).mean():.4f}")
執行結果:
兩兩 t 檢定(6 次,不校正)至少一次顯著:0.2019
Bonferroni(門檻 0.05/6)至少一次顯著:0.0415
一次 ANOVA F 檢定顯著:0.0472
Tukey HSD 至少一組顯著:0.0485
說明:4 組平均其實完全相同(H0 為真),每組 8 人,模擬 10,000 次:
- 不校正的 6 次 t 檢定,約 20% 的實驗會出現至少一次「顯著」(比理論 26.5% 低,因為 6 次比較共用資料、並不獨立,但仍遠超過 5%)。
- 一次 ANOVA、Tukey HSD、Bonferroni 都把整體型一錯誤率控制在 5% 左右。
儲存格 12:畫出 ANOVA
fig, axes = plt.subplots(2, 2, figsize=(13, 9))

# 左上:各年級睡眠時數(盒形圖+個別資料點)
ax = axes[0, 0]
ax.boxplot(groups, tick_labels=order)
for i, g in enumerate(groups, start=1):
    ax.scatter(np.full(len(g), i) + rng.uniform(-0.08, 0.08, len(g)), g, s=14, color="#4C72B0", alpha=0.7)
ax.axhline(grand, color="#C44E52", linestyle="--", label=f"總平均 = {grand:.2f}")
ax.set_title(f"各年級睡眠時數:F = {F:.2f},p = {p_F:.3f},η² = {eta2:.3f}")
ax.set_ylabel("睡眠時數(小時)")
ax.legend(fontsize=9)

# 右上:F 分配與觀察到的 F
ax = axes[0, 1]
fs = np.linspace(0, 6, 400)
ax.plot(fs, stats.f.pdf(fs, df_b, df_w), color="black", lw=2, label=f"H0 下的 F({df_b}, {df_w})")
fc = stats.f.ppf(0.95, df_b, df_w)
ax.fill_between(fs[fs >= fc], stats.f.pdf(fs[fs >= fc], df_b, df_w), color="#C44E52", alpha=0.5, label=f"拒絕域 F > {fc:.2f}")
ax.axvline(F, color="#4C72B0", linestyle="--", label=f"觀察 F = {F:.2f}")
ax.set_title("F 檢定:組間變異 ÷ 組內變異")
ax.set_xlabel("F")
ax.set_ylabel("密度")
ax.legend(fontsize=9)

# 左下:Tukey HSD 95% 同時信賴區間
ax = axes[1, 0]
ci = tk.confidence_interval(0.95)
for r, (i, j) in enumerate(pairs):
    diff = groups[i].mean() - groups[j].mean()
    sig = tk.pvalue[i, j] < 0.05
    ax.plot([ci.low[i, j], ci.high[i, j]], [r, r], color="#C44E52" if sig else "#4C72B0", lw=3)
    ax.plot(diff, r, "o", color="black")
ax.axvline(0, color="gray", linestyle="--")
ax.set_yticks(range(len(pairs)), [f"{order[i]} − {order[j]}" for i, j in pairs])
ax.set_title("Tukey HSD:平均差的 95% 同時信賴區間(含 0 即不顯著)")
ax.set_xlabel("平均睡眠時數差(小時)")

# 右下:雙因子交互作用圖(教學假設資料)
ax = axes[1, 1]
means = exam.groupby(["方法", "睡眠"])["成績"].mean().unstack()[["睡眠不足", "睡眠充足"]].loc[methods]
for mth, color in zip(methods, ["#8DA0CB", "#C44E52", "#55A868"]):
    ax.plot(["睡眠不足", "睡眠充足"], means.loc[mth], "o-", lw=2, color=color, label=mth)
ax.set_title("交互作用圖(教學假設資料):線不平行 → 可能有交互作用")
ax.set_ylabel("平均成績")
ax.legend(fontsize=9)

plt.tight_layout()
plt.savefig("unit07_charts.png", dpi=120)
plt.show()
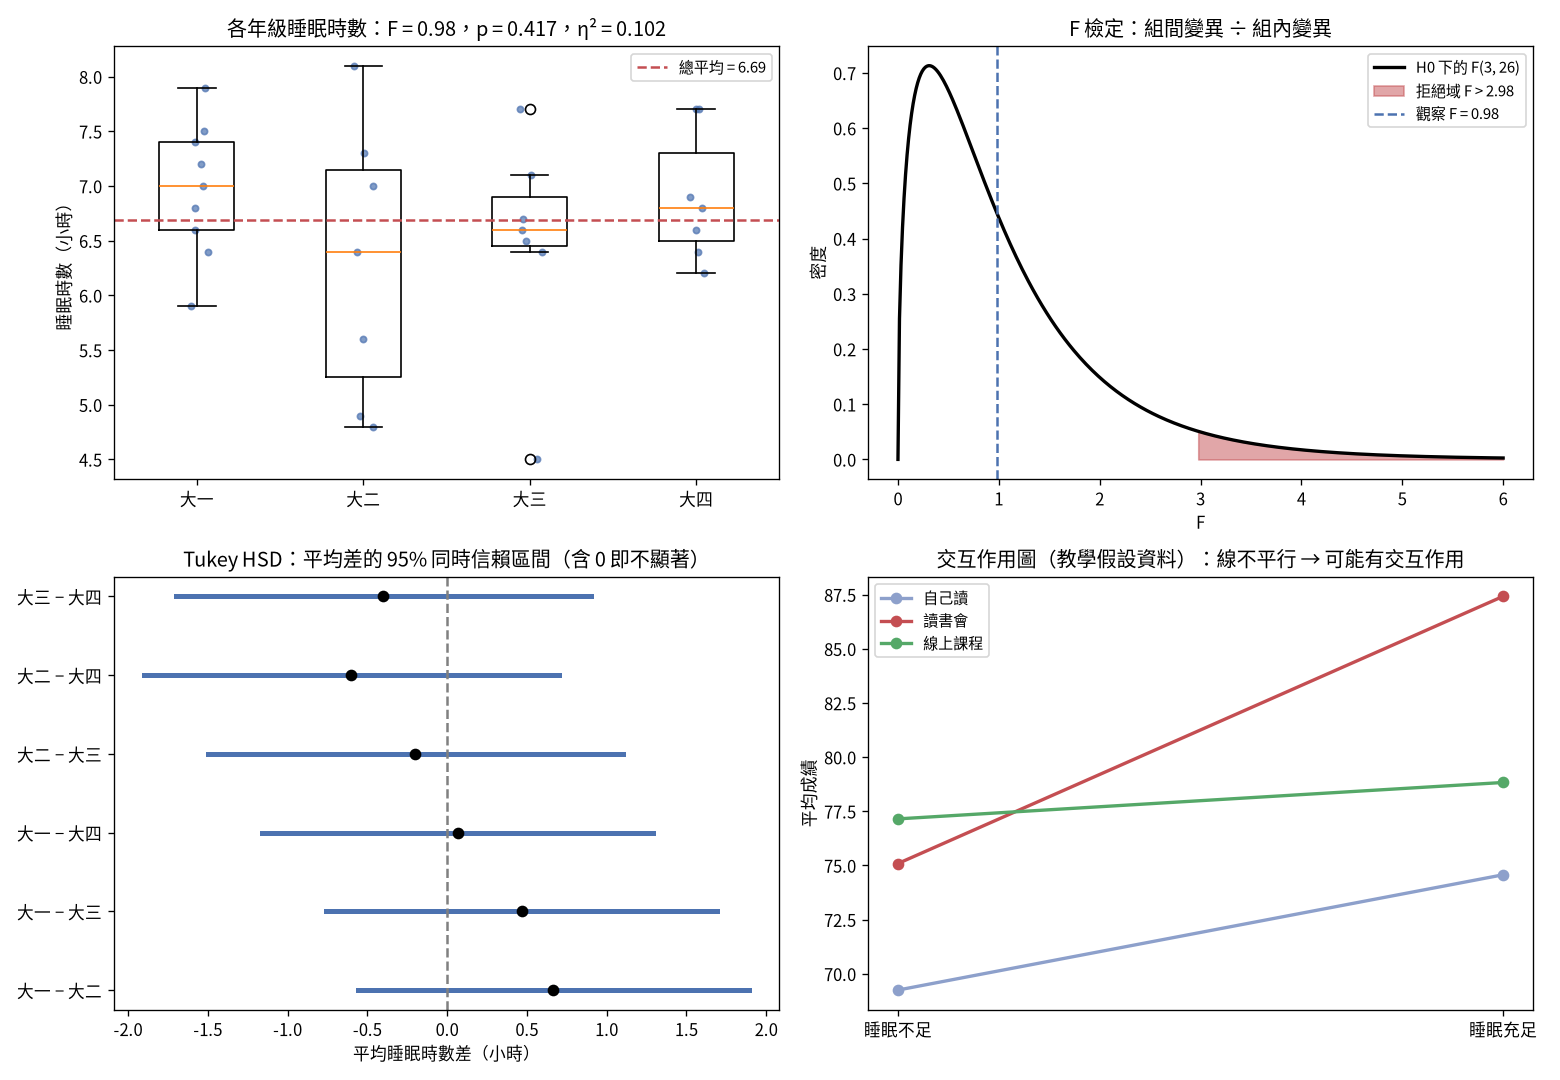
圖表解讀:
- 左上:各年級的資料點大幅重疊,組內差異遠大於組間差異。
- 右上:觀察到的 F ≈ 0.98 落在 F 分配的主體,離紅色拒絕域(F > 2.98)很遠。
- 左下:Tukey HSD 的 6 個同時信賴區間都跨過 0(藍色),沒有任何一組顯著不同。
- 右下:交互作用圖中,讀書會的線特別陡、與其他兩條線不平行,對應顯著的交互作用。
七、本單元重點整理
| 主題 | 重點 |
|---|---|
| 為什麼用 ANOVA | 兩兩 t 檢定會讓整體型一錯誤率暴增;ANOVA 一次檢定所有組 |
| 邏輯 | SS總 = SS組間 + SS組內;F = MS組間/MS組內,H0 為真時 F ≈ 1 |
| 工具 | stats.f_oneway、statsmodels ols + anova_lm |
| 效果量 | η² = SS組間/SS總;小樣本參考 ω² |
| 假設 | 獨立、常態、變異數相等(Levene);不等時用 Welch ANOVA |
| 事後比較 | ANOVA 顯著後用 Tukey HSD,控制整體錯誤率 |
| 無母數 | Kruskal-Wallis 比較等級,不需常態 |
| 雙因子 | 兩個主效果+交互作用;線不平行 → 交互作用 |
八、練習題
第 1 題|系所與睡眠時數
用 students.csv,以 department(系所)分組,檢定各系平均睡眠時數是否相同(α = 0.05),並計算 η²。
第 2 題|系所與運動次數
以 department 分組比較 exercise_per_week:
(a) 做 ANOVA 與 Levene 檢定。
(b) 觀光系平均每週運動約 2.9 次、財金系約 1.2 次,差距超過一倍,為什麼 ANOVA 和 Tukey HSD 都不顯著?
第 3 題|補完 ANOVA 表
某研究比較 3 種教學法,共 45 位學生(每組 15 人,教學假設),得到 SS組間 = 120、SS組內 = 630。請算出各自由度、MS、F、p 值與 η²,並下結論。
第 4 題|生活費與年級
用 ANOVA 與 Kruskal-Wallis 檢定各年級的每月生活費 monthly_allowance 是否不同。為什麼生活費這類變數適合補做 Kruskal-Wallis?
第 5 題|觀念題:判斷對錯
(a) ANOVA 顯著,代表每一組的平均數都彼此不同。
(b) H0 為真時,F 值應該接近 1。
(c) 5 組資料兩兩做 t 檢定共 10 次,整體型一錯誤率仍是 5%。
(d) 交互作用圖中各條線互相平行,代表兩個因子之間沒有交互作用。
(e) 同一批學生在期初、期中、期末各測一次,可以直接用一般的單因子 ANOVA。
九、練習題參考答案
📝 建議先自己作答,再對照答案喔!
第 1 題
import pandas as pd
from scipy import stats

df1 = pd.read_csv("students.csv", encoding="utf-8-sig")
print(df1.groupby("department")["sleep_hours"].agg(["count", "mean", "std"]).round(3).to_string())
g1 = [x.to_numpy() for _, x in df1.groupby("department")["sleep_hours"]]
r1 = stats.f_oneway(*g1)
print(f"F = {r1.statistic:.4f},p = {r1.pvalue:.4f}")
ss_b = sum(len(g) * (g.mean() - df1["sleep_hours"].mean()) ** 2 for g in g1)
ss_t = ((df1["sleep_hours"] - df1["sleep_hours"].mean()) ** 2).sum()
print(f"η² = {ss_b / ss_t:.4f}")
執行結果:
            count   mean    std
department
企管系          6  6.250  0.758
觀光系          9  6.767  0.992
財金系          9  6.856  1.038
資管系          6  6.750  0.616
F = 0.6040,p = 0.6183
η² = 0.0651
F ≈ 0.60,p ≈ 0.62 > 0.05,無法拒絕 H0,沒有證據顯示各系平均睡眠時數不同。η² ≈ 0.065,系所只解釋約 6.5% 的變異,而且小樣本下這個數字還會高估。
第 2 題
import pandas as pd
from scipy import stats

df2 = pd.read_csv("students.csv", encoding="utf-8-sig")
names = sorted(df2["department"].unique())
g2 = [df2.loc[df2["department"] == d, "exercise_per_week"].to_numpy() for d in names]
print("各系平均:", {d: round(float(g.mean()), 3) for d, g in zip(names, g2)})
print(f"ANOVA:p = {stats.f_oneway(*g2).pvalue:.4f};Levene:p = {stats.levene(*g2, center='median').pvalue:.4f}")
tk2 = stats.tukey_hsd(*g2)
for i in range(4):
    for j in range(i + 1, 4):
        print(f"{names[i]} − {names[j]}:差 = {g2[i].mean() - g2[j].mean():+.3f},調整後 p = {tk2.pvalue[i, j]:.4f}")
執行結果:
各系平均: {'企管系': 1.333, '觀光系': 2.889, '財金系': 1.222, '資管系': 2.167}
ANOVA:p = 0.2133;Levene:p = 0.1918
企管系 − 觀光系:差 = -1.556,調整後 p = 0.3665
企管系 − 財金系:差 = +0.111,調整後 p = 0.9994
企管系 − 資管系:差 = -0.833,調整後 p = 0.8493
觀光系 − 財金系:差 = +1.667,調整後 p = 0.2200
觀光系 − 資管系:差 = +0.722,調整後 p = 0.8678
財金系 − 資管系:差 = -0.944,調整後 p = 0.7477
(a) ANOVA p ≈ 0.21,Levene p ≈ 0.19,皆不顯著。
(b) 每組只有 6~9 人、組內差異又大(有人不運動、有人一週運動 5 次),標準誤很大;Tukey 還要校正 6 次比較,門檻更嚴。不顯著不代表沒有差異,只是這份小樣本的證據不足(檢定力不夠)。
第 3 題
from scipy import stats

k3, N3 = 3, 45
ss_b3, ss_w3 = 120.0, 630.0
ms_b3, ms_w3 = ss_b3 / (k3 - 1), ss_w3 / (N3 - k3)
F3 = ms_b3 / ms_w3
print(f"df = ({k3 - 1}, {N3 - k3}),MS組間 = {ms_b3:.1f},MS組內 = {ms_w3:.1f}")
print(f"F = {F3:.3f},p = {stats.f.sf(F3, k3 - 1, N3 - k3):.4f},η² = {ss_b3 / (ss_b3 + ss_w3):.3f}")
執行結果:
df = (2, 42),MS組間 = 60.0,MS組內 = 15.0
F = 4.000,p = 0.0257,η² = 0.160
df組間 = 3 − 1 = 2,df組內 = 45 − 3 = 42;MS組間 = 60、MS組內 = 15;F = 4.0,p ≈ 0.026 < 0.05,拒絕 H0,至少有一種教學法的平均成績不同;η² = 0.16,屬於大效果。下一步應以 Tukey HSD 找出是哪幾種教學法不同。
第 4 題
import pandas as pd
from scipy import stats

df4 = pd.read_csv("students.csv", encoding="utf-8-sig")
g4 = [x.to_numpy() for _, x in df4.groupby("grade")["monthly_allowance"]]
print(f"ANOVA:p = {stats.f_oneway(*g4).pvalue:.4f}")
print(f"Kruskal-Wallis:H = {stats.kruskal(*g4).statistic:.4f},p = {stats.kruskal(*g4).pvalue:.4f}")
執行結果:
ANOVA:p = 0.9626
Kruskal-Wallis:H = 0.6313,p = 0.8892
ANOVA p ≈ 0.96、Kruskal-Wallis p ≈ 0.89,結論一致:各年級生活費沒有顯著差異。生活費通常右偏、可能有少數特別高的值,影響平均數與 F 檢定;Kruskal-Wallis 使用等級,不受極端值影響,是很好的穩健性檢查。
第 5 題
(a) 錯。只代表「至少一組不同」,要用事後比較找出是哪幾組。
(b) 對。H0 為真時組間與組內都只反映隨機誤差,MS 相近,F 約為 1。
(c) 錯。若彼此獨立,約為 1 − 0.95¹⁰ ≈ 40%;即使比較之間相關,仍遠高於 5%。
(d) 對。平行代表一個因子的效果在另一個因子的各水準下都一樣(實務上還要看交互作用檢定)。
(e) 錯。同一批人重複測量,資料不獨立,應改用重複量數 ANOVA 或混合模型。
💡 小技巧:做 ANOVA 時,先畫盒形圖+資料點,再看 F 檢定。圖能讓你一眼看出組內差異有多大、有沒有極端值、變異數是否差很多。
下一單元預告
ANOVA 處理的是「類別變數(年級、系所)對數值變數的影響」。如果解釋變數本身也是數值,例如「睡眠時數越多,滿意度越高嗎?」「運動次數和身高有關嗎?」就要用相關與迴歸。單元 8 將介紹相關係數、散布圖與簡單線性迴歸,並說明為什麼「相關不等於因果」。
← 回到單元 6:假設檢定——用資料回答「是不是真的有差?」
👉 單元 8:相關與簡單迴歸(即將推出)
© SuhsiungAI學習教室(suhsiung.com)・統計應用課程・授課教師:蘇志雄。本單元範例資料 students.csv 為教學用虛構資料,與任何真實人物無關;讀書方法與考試成績、教學法比較等例子中的數字,除另有說明外,皆為教學用假設或簡化,不代表任何真實學校、機構或研究結果。